GLM 5.3 Flash и Qwen3.8 Flash: цена диалога и результат
GLM получила 92 балла за продажи, Qwen – 74. Но диалог Qwen стоил вдвое дешевле. Разбираю ответы, ошибки в окупаемости и задержку двух моделей.
Разборы, кейсы и практика внедрения ИИ в бизнес-процессы
Найдено: 30 статей

GLM получила 92 балла за продажи, Qwen – 74. Но диалог Qwen стоил вдвое дешевле. Разбираю ответы, ошибки в окупаемости и задержку двух моделей.

В сентябре я проверил модели на русских учебных текстах и симуляции продаж. Одни набирали больше баллов за уроки, другие — за разговоры; дешёвый быстрый ответ тоже мог придумать цифры. Показываю, что можно вынести из трёх волн и почему смена оценки между ними сама по себе не доказывает деградацию.

Собрал Model Compass, чтобы выбирать модель под конкретную работу. Показываю, как читать цену, качество и скорость, выбирать оркестратора и воркера и сравнивать две 3D-карты от Sol и Opus.

OpenAI выпустила GPT-6 Sol и Luna и пообещала вдвое меньше ошибок. Мы прогнали обе модели через свои задачи и повторили замер. Sol стала лучшей в генерации курсов. Luna 6 оказалась хуже предыдущей Luna 5.6 – и в текстах, и особенно в продажах.

Главная проблема памяти ИИ – не забывчивость, а устаревание: система находит и старую цену, и новую, и уверенно называет старую. Чужие замеры показывают, что модель сама решает это плохо, а наш корпус на 68 413 записей объяснил почему: ни одна запись не помечена как отменённая.

Глубокое исследование от нейросети экономит неделю работы – и оно же убедительно врёт. Шесть приёмов, которыми отчёт выглядит доказанным: число без знаменателя, цифры-картинки, шесть фактов из одного блога. Все примеры из отчётов, которые заказывал я сам.

36 вопросов, которые собственник задаёт своим людям на планёрке, и которые можно задать базе напрямую: почему мы проигрываем, где сделки застревают, у кого перегруз, какие возражения повторяются. Что нужно вашей CRM, чтобы она на них отвечала, что написать в ТЗ и как принимать работу у подрядчика.

Поиск по базе отвечает на два разных вопроса: «найди вот эту сделку» и «что у нас есть про срыв сроков». Отвечают на них разные механизмы, и объединение «по умолчанию» ухудшает результат: в нашем замере на 138 вопросах точность упала со 100 % до 57 %.

Заказчик спросил: раз это одна и та же модель, берём ту, у которой открытые веса – она же дешевле. Мы прогнали обе версии Qwen3.8 через генерацию текстов и живые диалоги. Открытая оказалась на 10% дороже на генерации и вровень на диалогах, а три запуска из пяти с первого раза вернули пустоту.

Мы прогнали десять моделей через сорок симулированных диалогов с трудным клиентом. Разница в качестве между самой дешёвой и самой дорогой – четыре балла из ста. Разница в цене одного диалога – 71 раз. На счёт влияют тариф и режим рассуждений; у шести маршрутов из десяти отключить его не удалось.

DeepSeek выпустил новую сборку флагманской модели после четырёх месяцев превью. Мы перегнали старую версию на той же шкале и получили 83 против 82 – ничью. Единственное измеримое улучшение оказалось не в качестве. Разбираем и второй повод сменить модель, который тоже ничего не значит.

Наш продающий ассистент приписал креслу сетчатую спинку, которой нет в каталоге. Пошли чинить – и нашли часть галлюцинации в собственном коде. Разбираю на замере четырёх моделей, что проверять кодом, что мерить и что записать в ТЗ подрядчику.

Голосовые сообщения бот расшифровывает меньше чем за два цента в минуту и делает это сегодня. А живой разговор упирается в задержку, и в нашем продовом замере 82% её создаёт не наш код.

Счёт за нейросеть можно уменьшить в разы, не меняя модель. Мы прогнали 400 запросов и посчитали, сколько стоит каждая настройка: провайдер, класс обслуживания, кэш, длина контекста. На боте с двумя сотнями обращений в день разница вышла в 439 раз.

Проверять работу ИИ второй моделью можно, и это дешевле любой ручной выборки. Ломается такой контроль не там, где боятся: не от глупости модели, а от того, что проверяющему можно подсказать, что проверяющих становится много и что проверку строят под слабость конкретной версии.

Прогнали восемь моделей через две реальные задачи на русском — генерацию обучающего контента и продающие диалоги. Самая дорогая модель когорты оказалась хуже самой дешёвой почти в пятьдесят раз по цене и на девять баллов по качеству. Разбираю, как выбирать модель под проект: почему у одной модели одиннадцать разных цен, что показывает разброс вместо среднего балла и почему англоязычный рейтинг ничего не говорит о работе на русском.

Alibaba выпустила Qwen 3.8 Max: 2,4 триллиона параметров, миллион контекста и первое место в медицинской категории Arena. Разбираю, что из этого проверяемо, сколько модель стоит на самом деле и почему клиент, требовавший самую дорогую модель на рынке, передумал за один разговор.

Я прогнал десять языковых моделей через живой B2B-диалог с жёстким клиентом. Одна выдумала клиентский кейс под торгом, другая восемь раз повторила свой ответ. Разбираю, что из этого следует заказчику ИИ-бота для продаж.

Пилот почти всегда получается: бот отвечает, отчёт собирается, демо проходит. А через квартал показатели стоят на месте. Разбираю, почему так выходит, где именно теряется ответственность за результат и что зафиксировать до старта, чтобы эффект было с чем сравнивать.

Anthropic разобрала 400 000 рабочих сессий с ИИ-агентом и выяснила: профессия почти не влияет на результат. У разработчиков 30% успеха, у остальных 26%. Разбираю, что из этого следует, если вы заказываете разработку, а не пишете код сами.

Между чат-ботом с GPT и AI-агентом — пропасть размером в полгода разработки. Разбираем архитектуру, компоненты и подводные камни AI-агентов без маркетингового булшита.

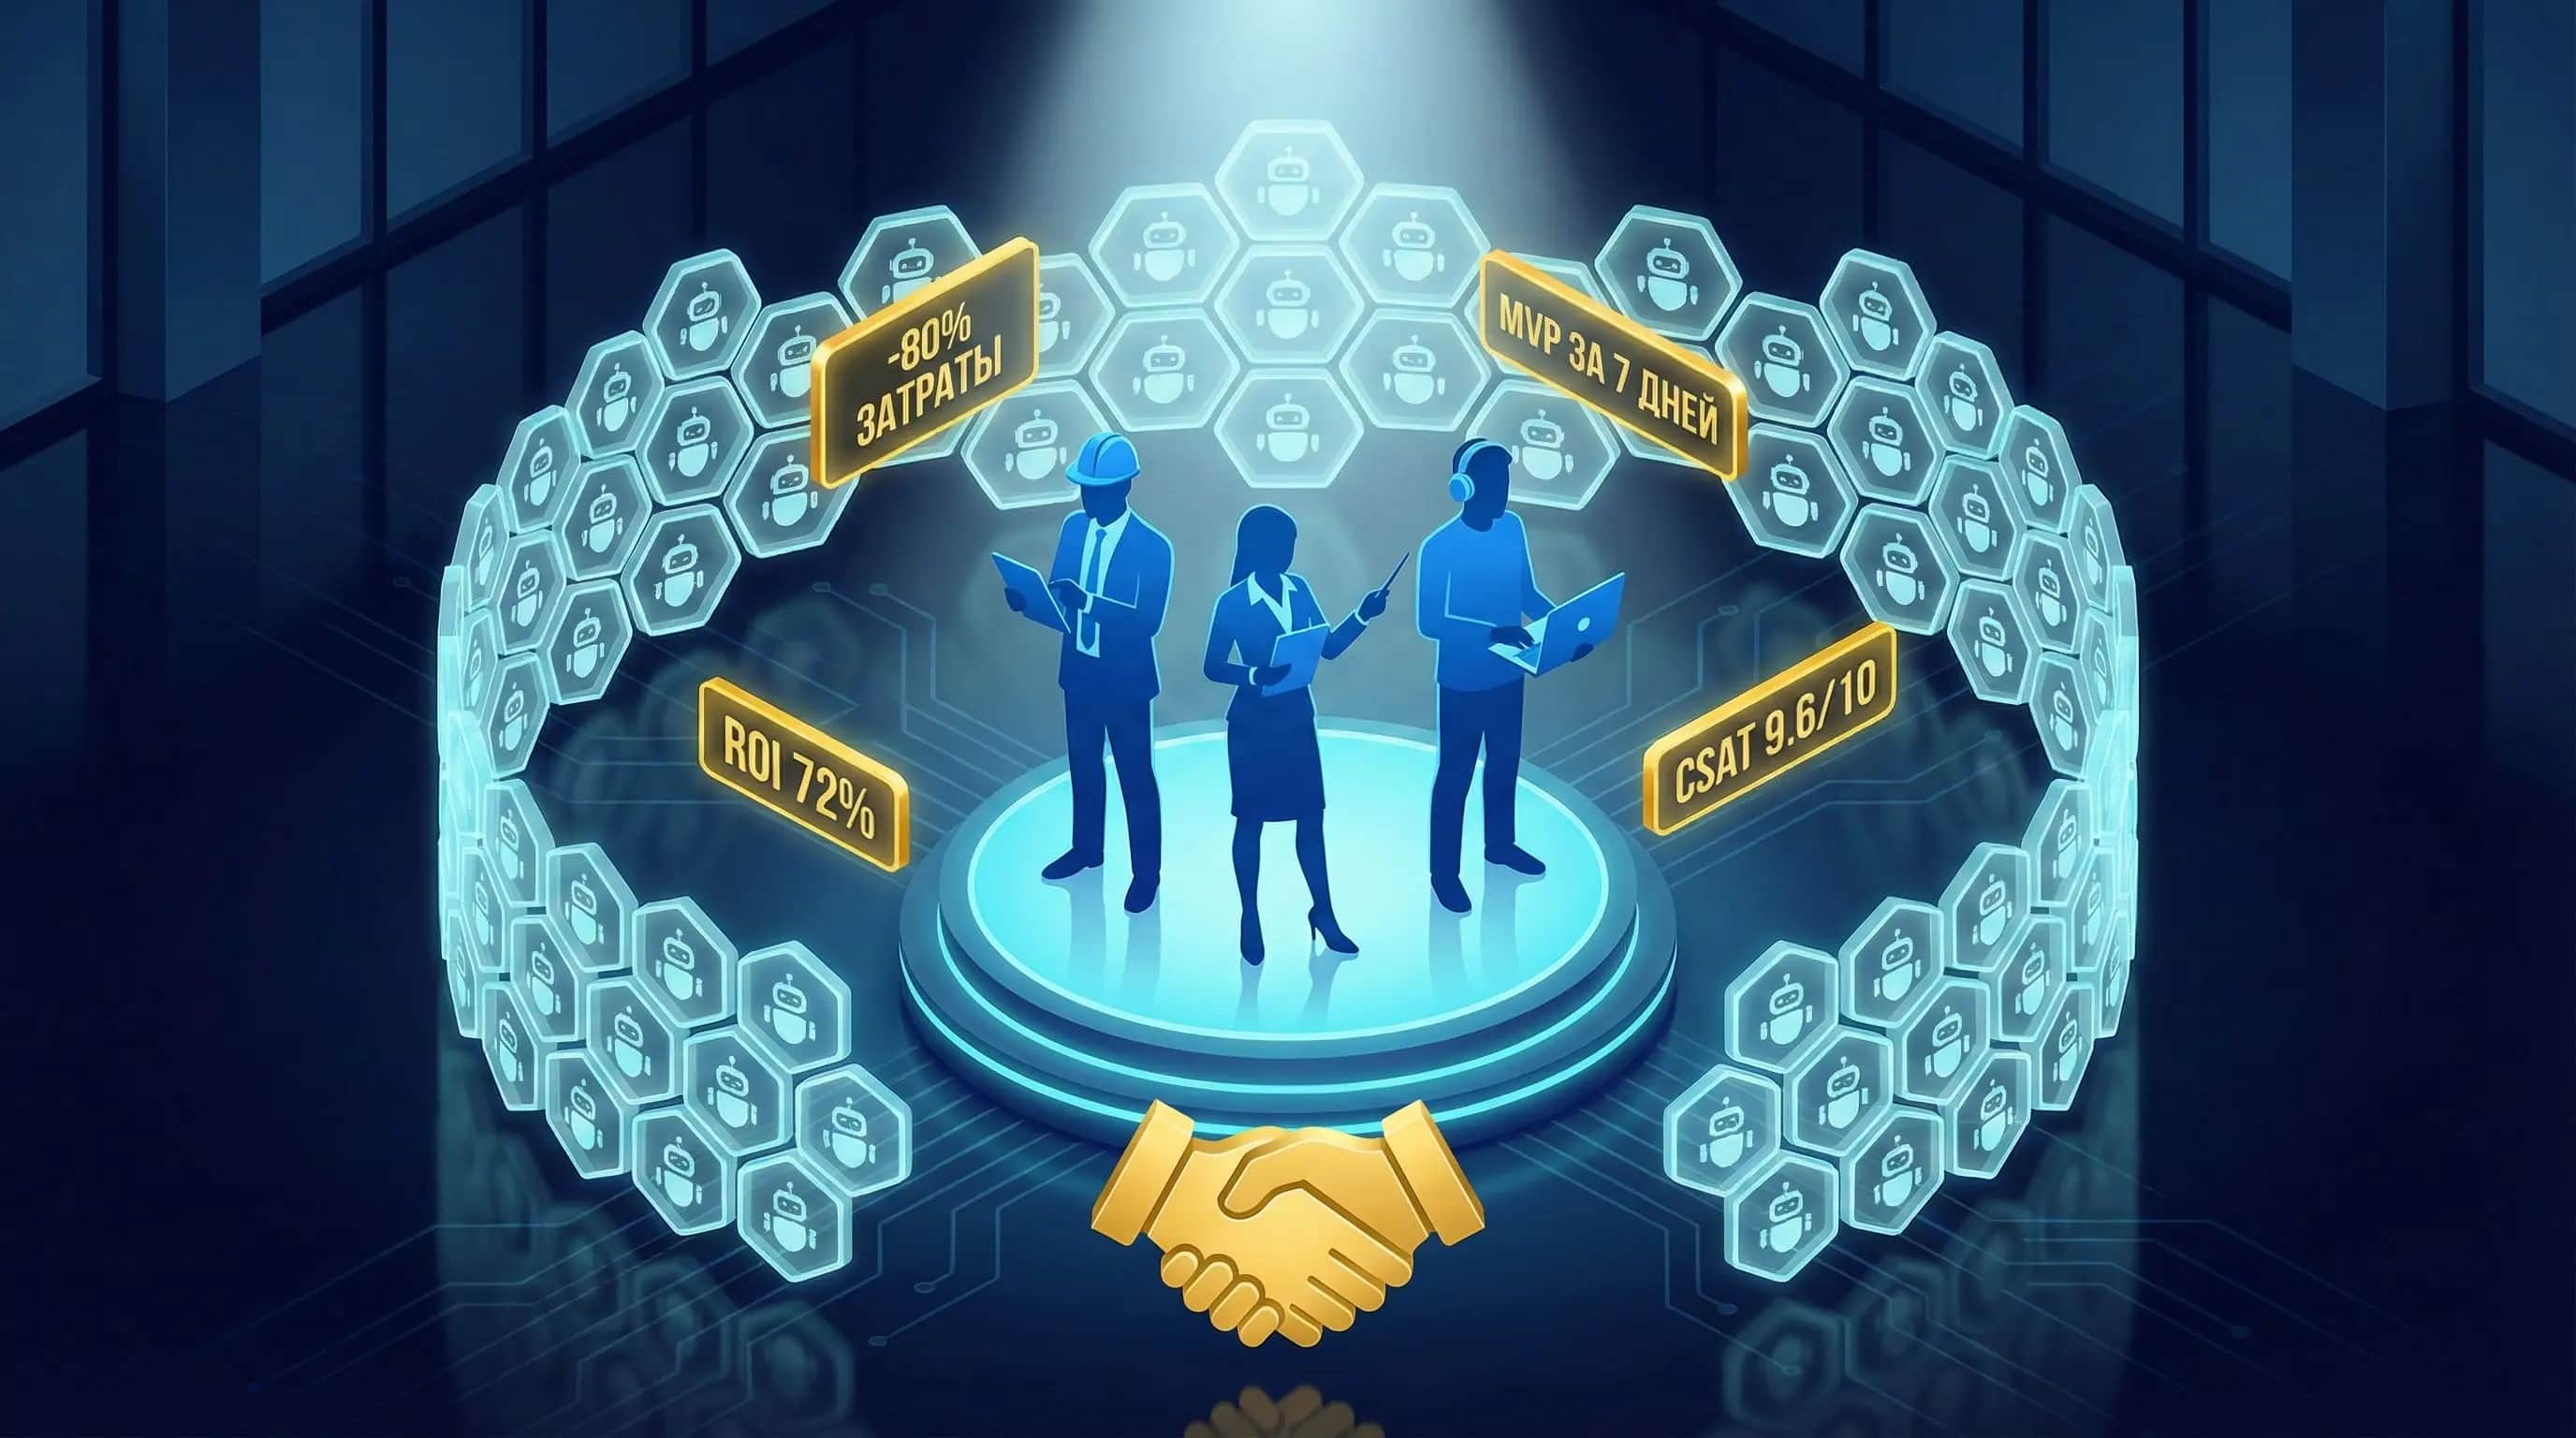
514 реализованных проектов. Средний ROI: 72%. Средняя экономия: 80% ФОТ. Дешевле на 80%, быстрее в 5-6 раз, качественнее благодаря автоматическим проверкам.

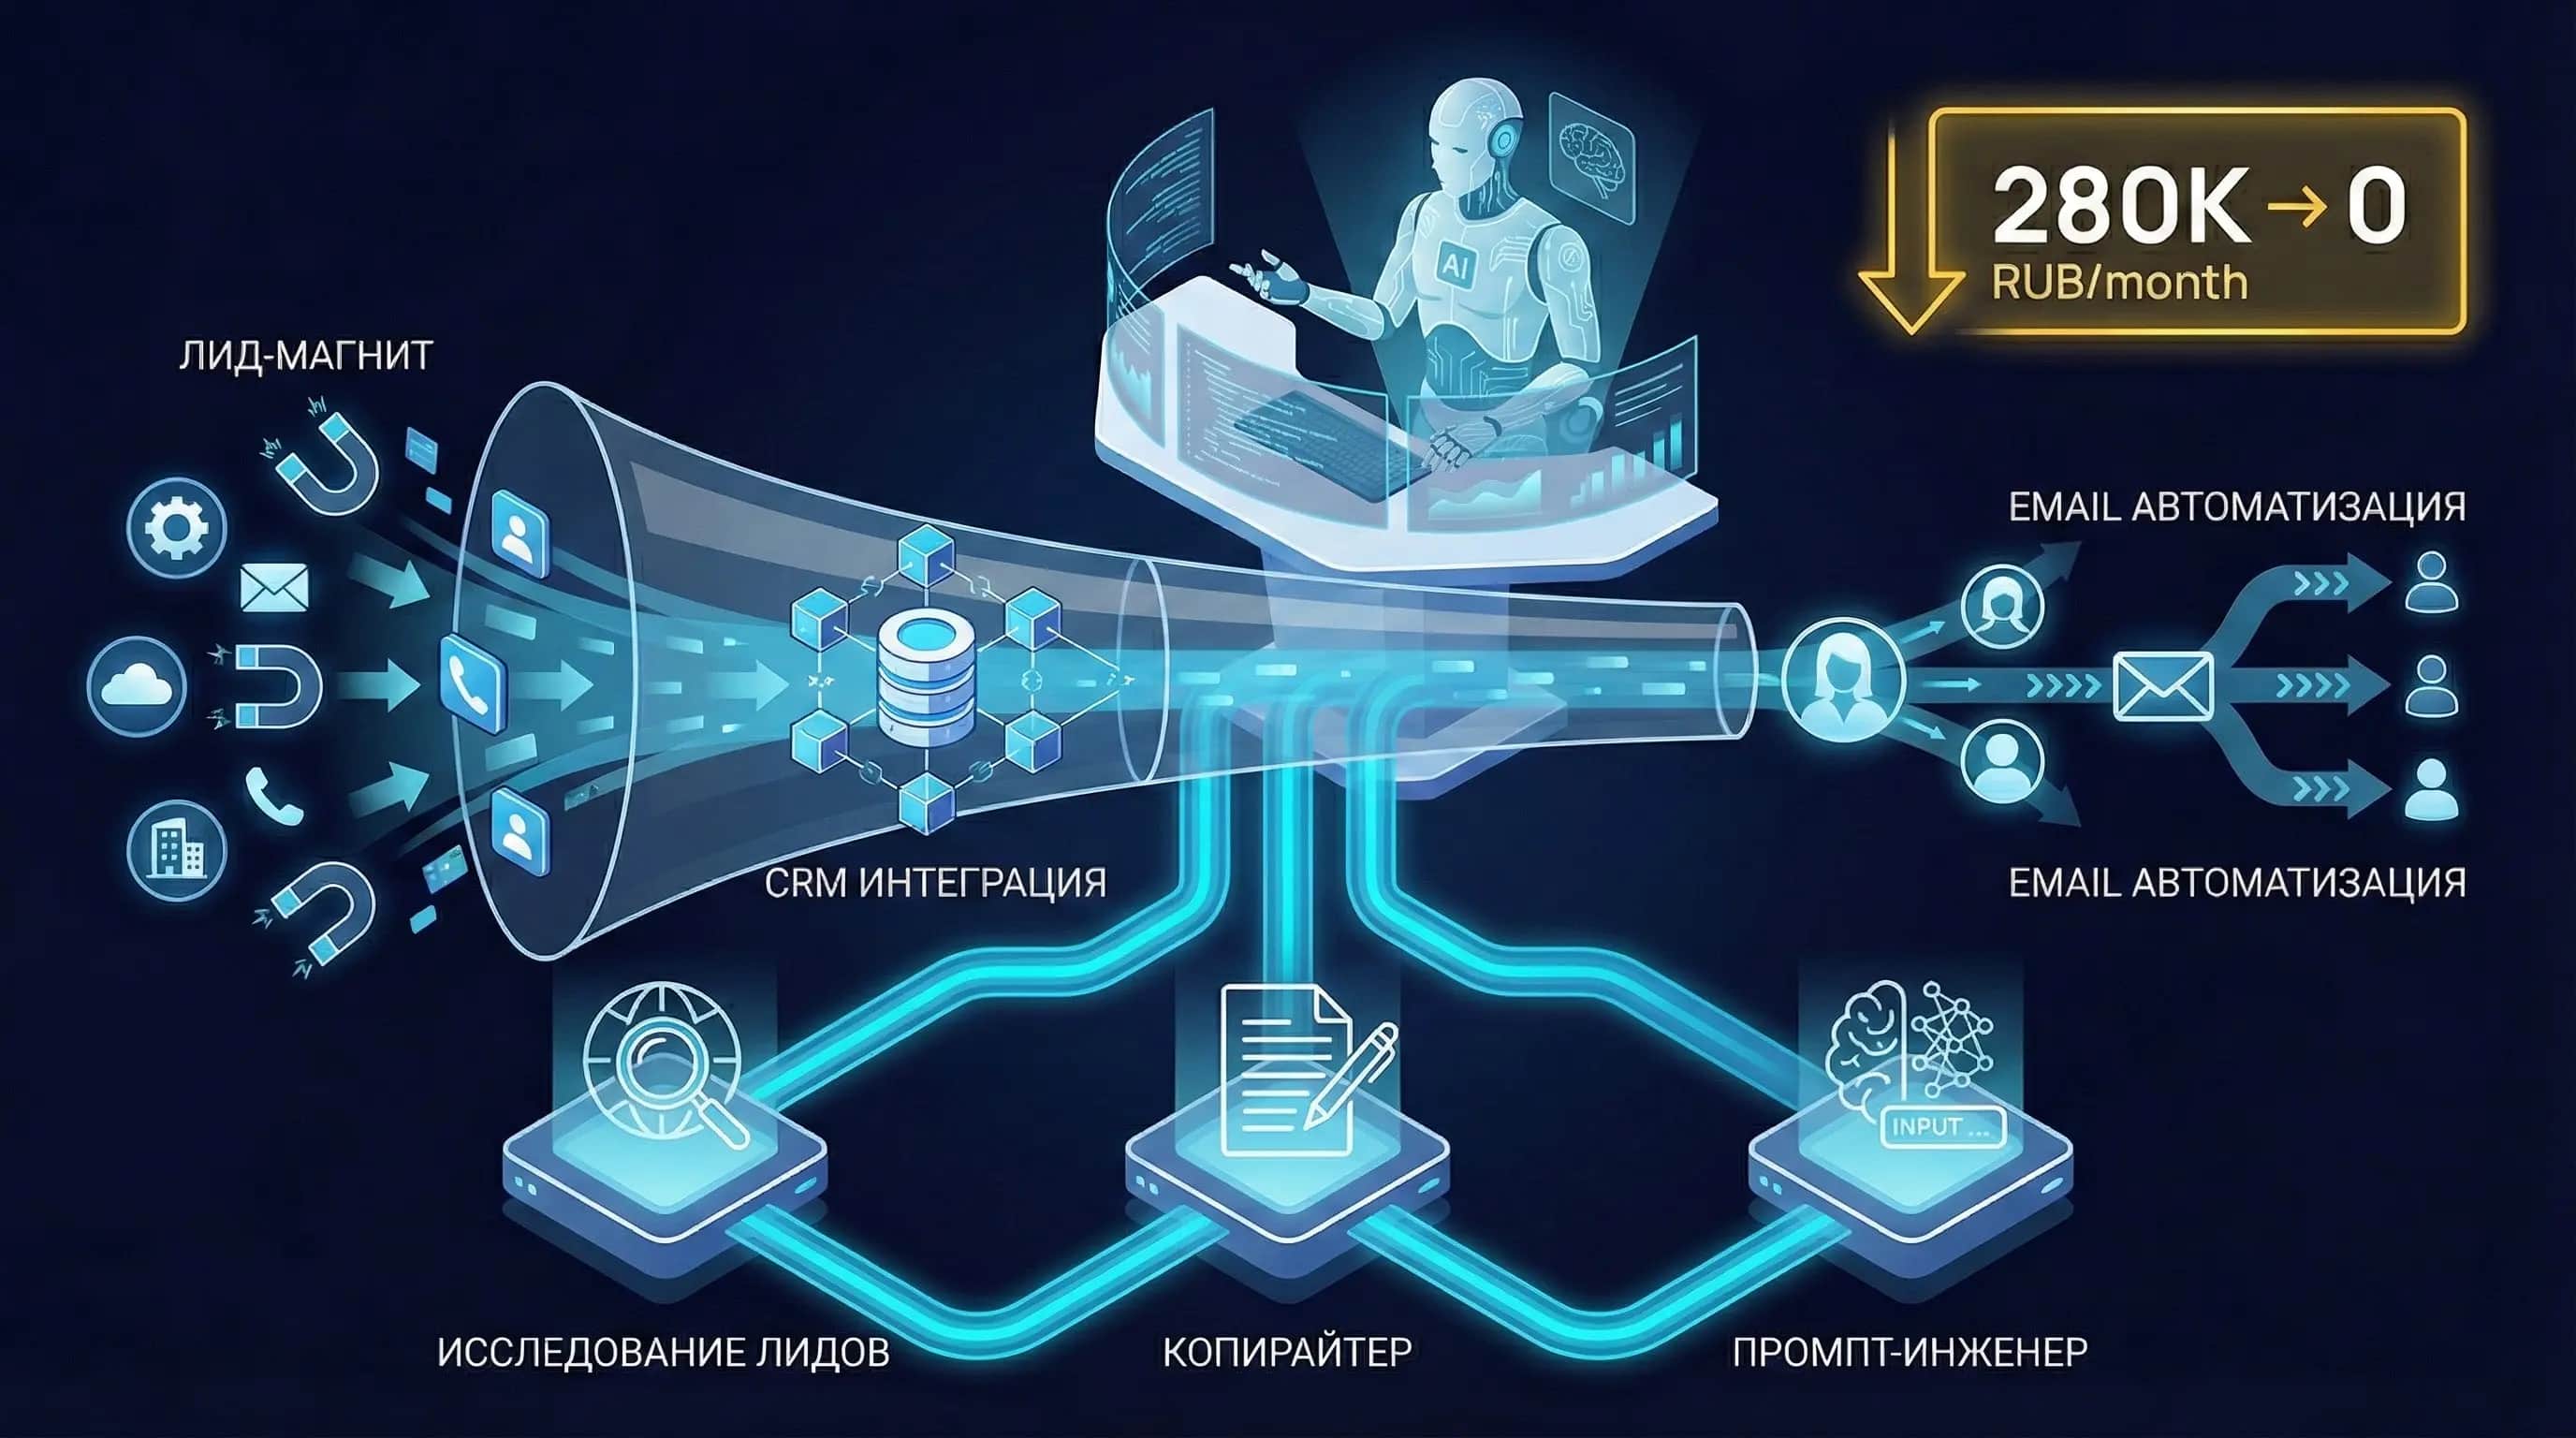
Сейлз-консультанты стоят от 150К/месяц. AI скиллы для поиска клиентов — бесплатно. Рассказываю, как мы автоматизировали лидогенерацию и контент-маркетинг в AI Dev Team.

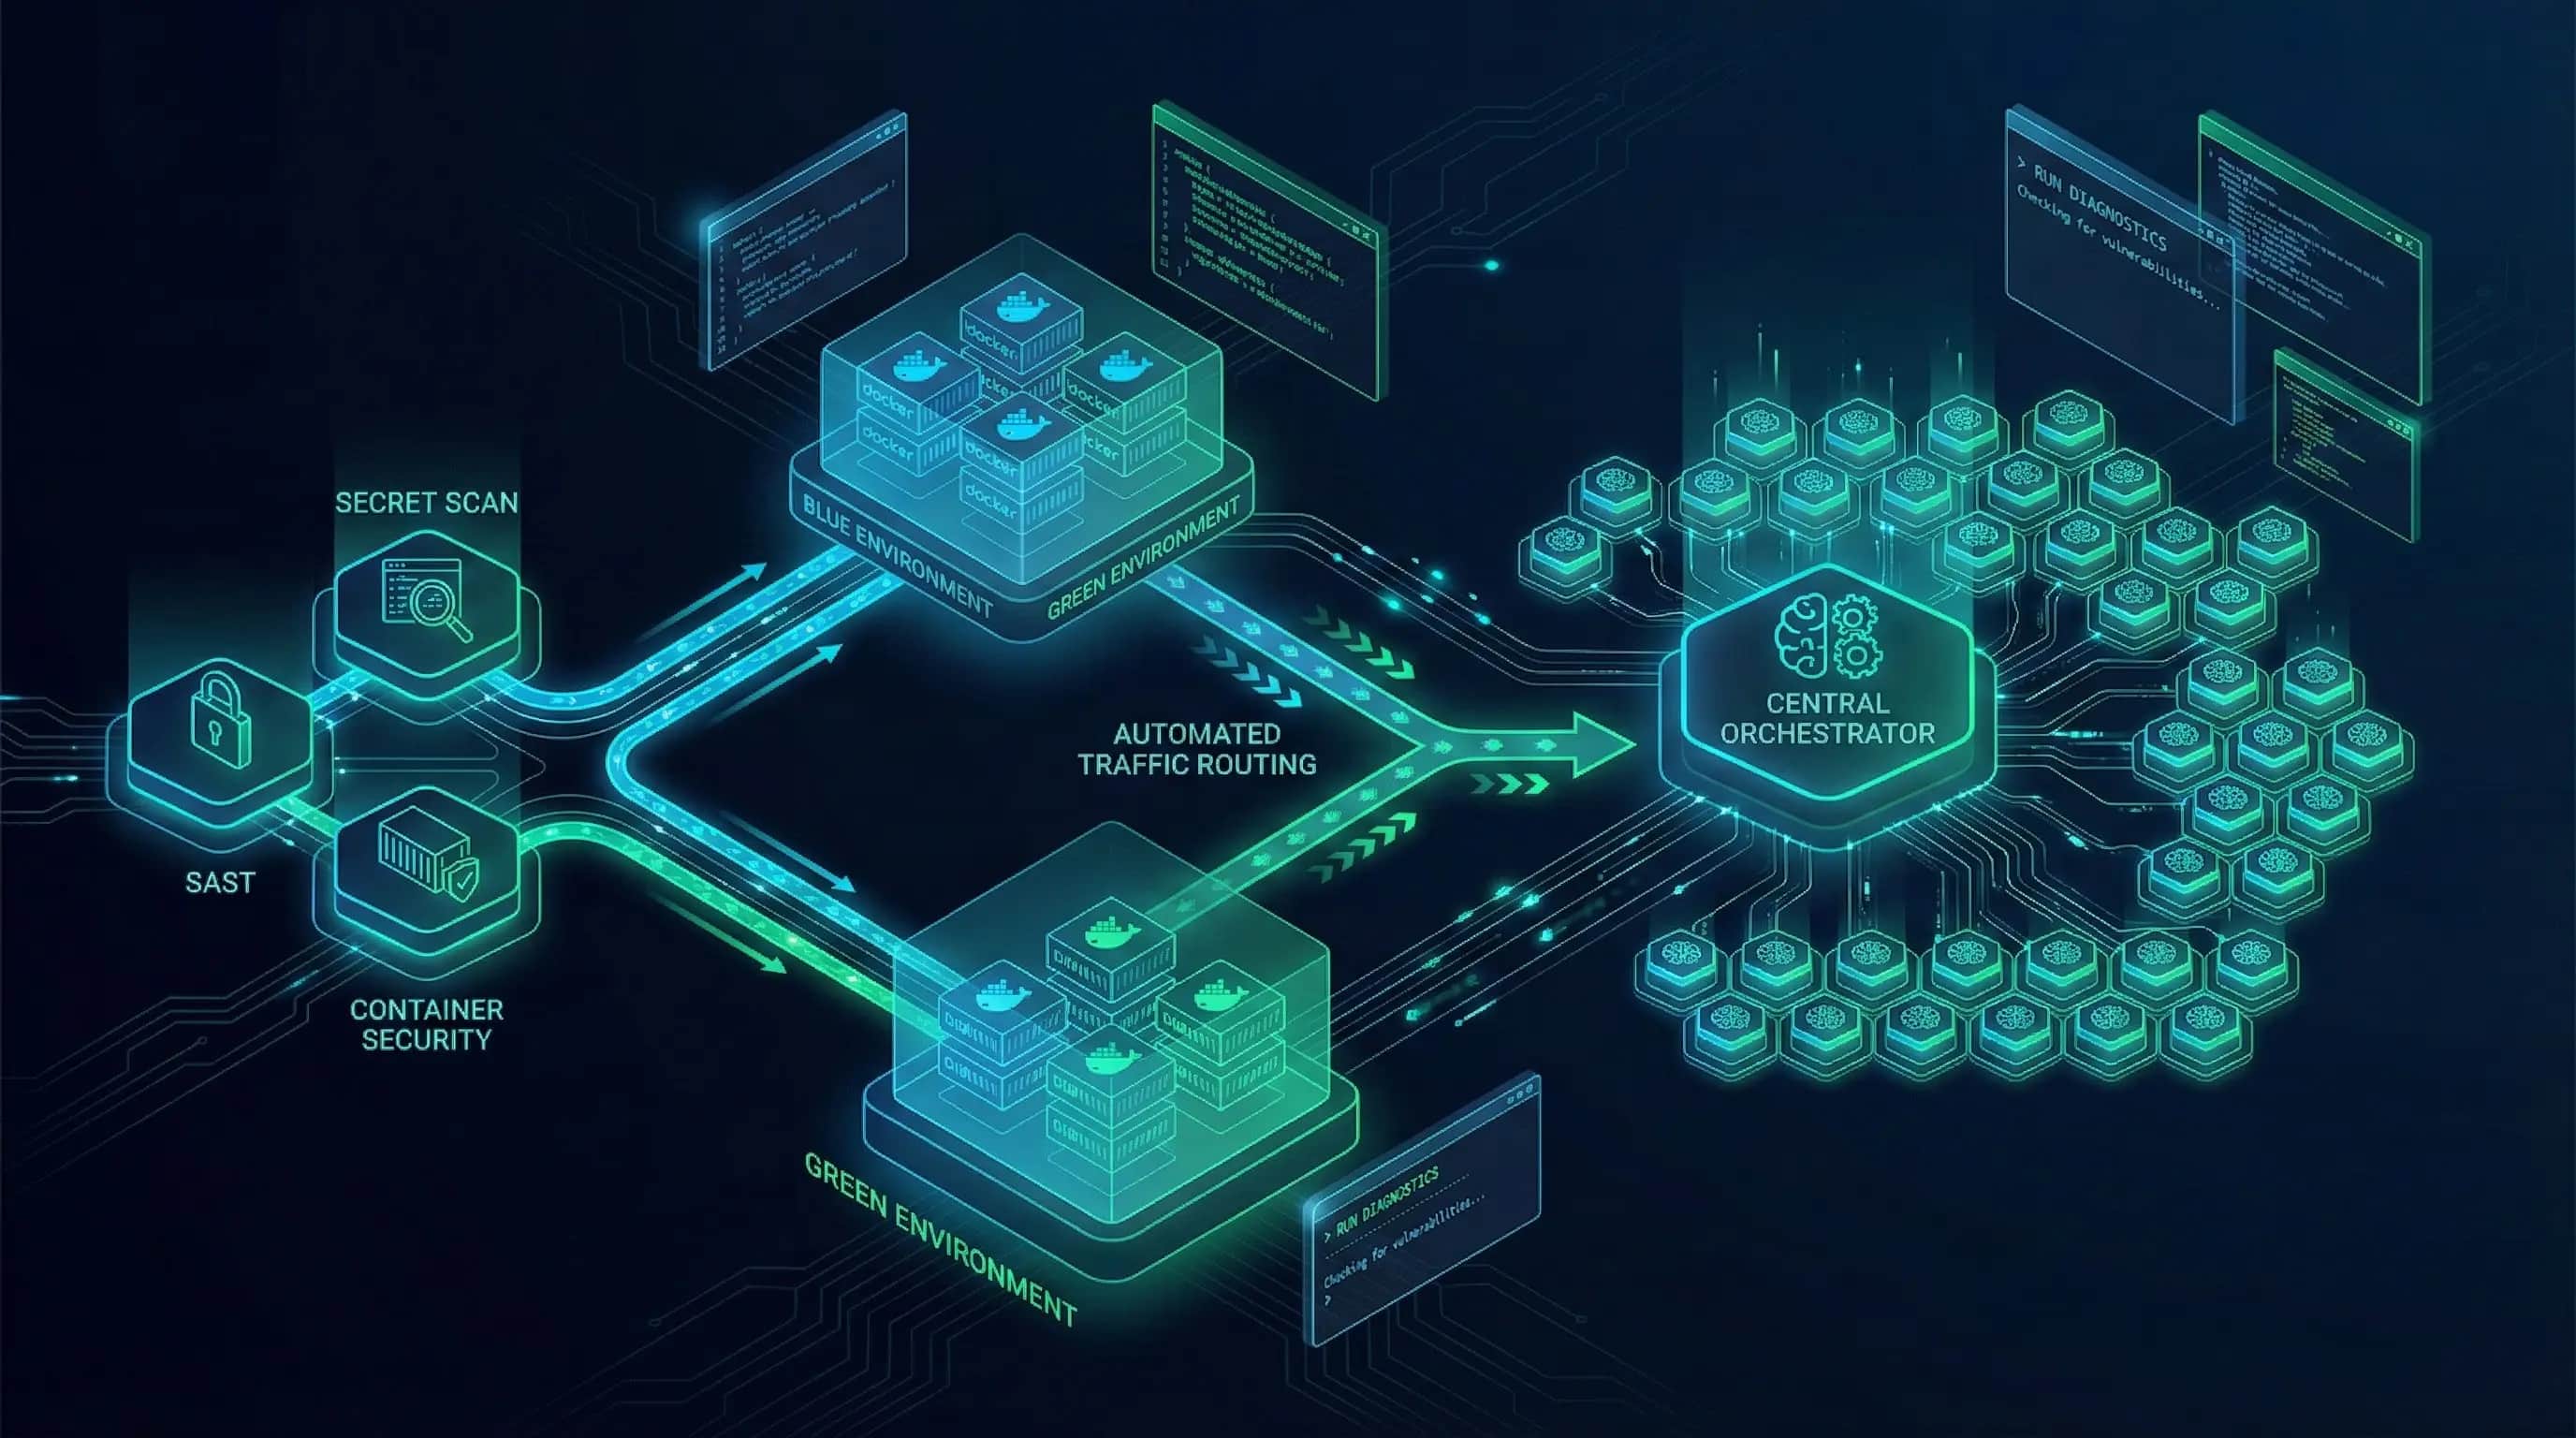
За последние два месяца я добавил в Claude Code Orchestrator Kit 44 новых специализированных агента и около 30 скиллов. Это не просто 'ещё агенты' — это готовые инженерные паттерны для реальных production-задач.

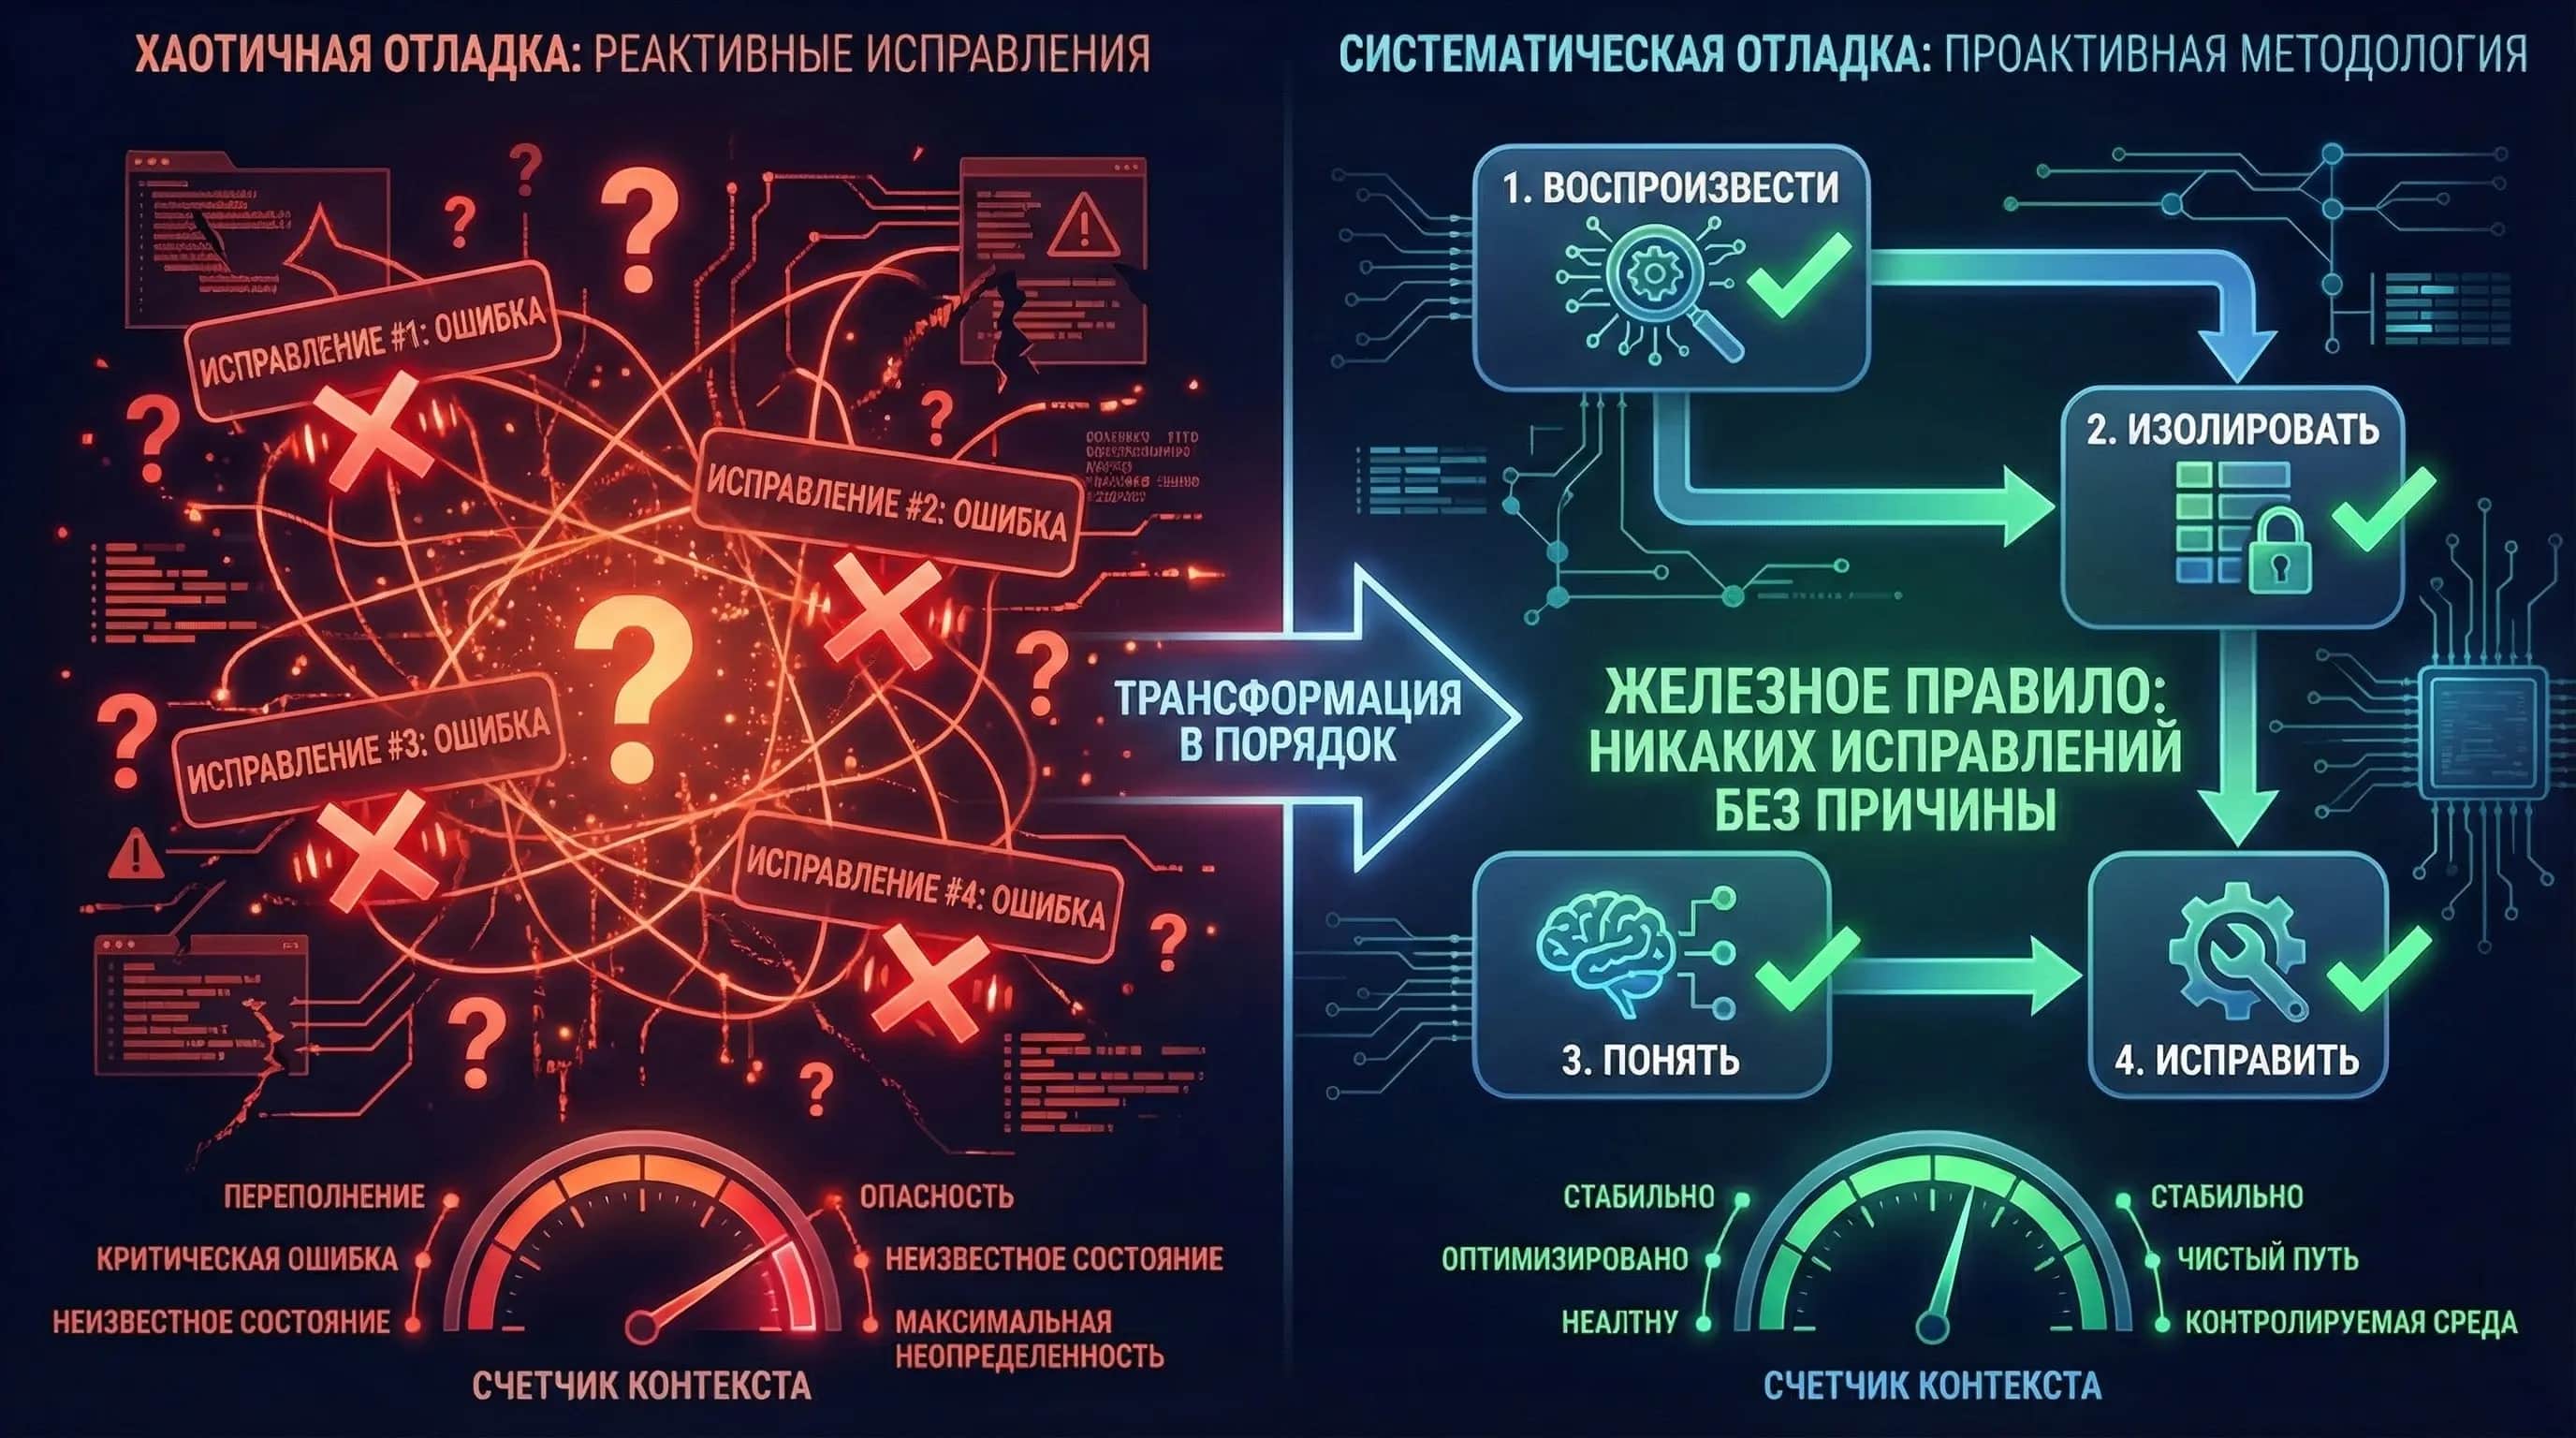
Я проанализировал 14 новых скиллов для Claude Code Orchestrator Kit. 5 из них критически полезны и уже интегрированы с агентами. Главный герой — systematic-debugging — методология систематического дебага вместо хаотичного 'угадывания' фиксов.

AI генерирует контент. Но кто проверяет, что этот контент не содержит галлюцинаций, соответствует педагогическим стандартам и не ушёл в Wikipedia-подобную сложность? Мы построили систему автоматической валидации с ROI 5,700-17,000x по сравнению с ручной проверкой.

Представьте: вы колл-центр недвижимости, записываете тысячи разговоров в день. Хотите обучить AI на этих данных для контроля качества обслуживания. Но разговоры полны персональных данных: имена клиентов, телефоны, паспортные данные, адреса.

В первой части я рассказал про главную идею: превратить Claude Code в профессиональный оркестратор с 33 специализированными агентами. Показал главный результат: -80% стоимости, 1-2 недели вместо 2-3 месяцев, 5-7 проектов одновременно.

Я руковожу IT-компанией DNA IT с 2013 года. Последние 2 года активно развиваю отдельное подразделение — AI Dev Team. И вот что интересно: всё больше клиентов выбирают AI-команду вместо традиционного отдела разработки.

В первой части я рассказал про главную идею: -80% стоимости, 1-2 недели вместо 2-3 месяцев, 5-7 проектов одновременно. Во второй части показал техническую архитектуру: оркестраторы + воркеры, meta-agent, health workflows, MCP switcher.