
23 октября Moonshot выпустила Kimi K3.1 Pro, а 26 октября OpenAI добавила GPT-6.1 Terra. Смотрю на обе новинки и пока не понимаю, куда ставить их в своей работе. С Sol 6.1 и моделями Anthropic выбор привычнее, а здесь приходится отдельно выяснять, за что платишь деньгами, временем или лимитом подписки.
Сильнее всего меня зацепили два графика Artificial Analysis на 27 октября. На одном новая Terra теряется рядом с существующими моделями. На другом Kimi уезжает вправо так далеко, что её преимущество по качеству уже хочется обсудить с секундомером в руках.
Но из графиков следуют разные выводы для разных режимов. После проверки релизов я бы поправил свою первую реакцию: у Terra есть применение, а для Kimi уже предлагают ускорение. Осталось понять, подходят ли эти варианты под мою работу.
Terra Max трудно предпочесть Sol Medium
Terra Max и Sol Medium получают по 48 баллов после округления в Intelligence Index. При этом задача AA стоит 0,40 доллара у Terra и 0,21 доллара у Sol Medium. За близкий общий результат Terra просит почти вдвое больше. Это данные сравнения Terra и таблицы AA, а не расчёт стоимости моего будущего запроса.
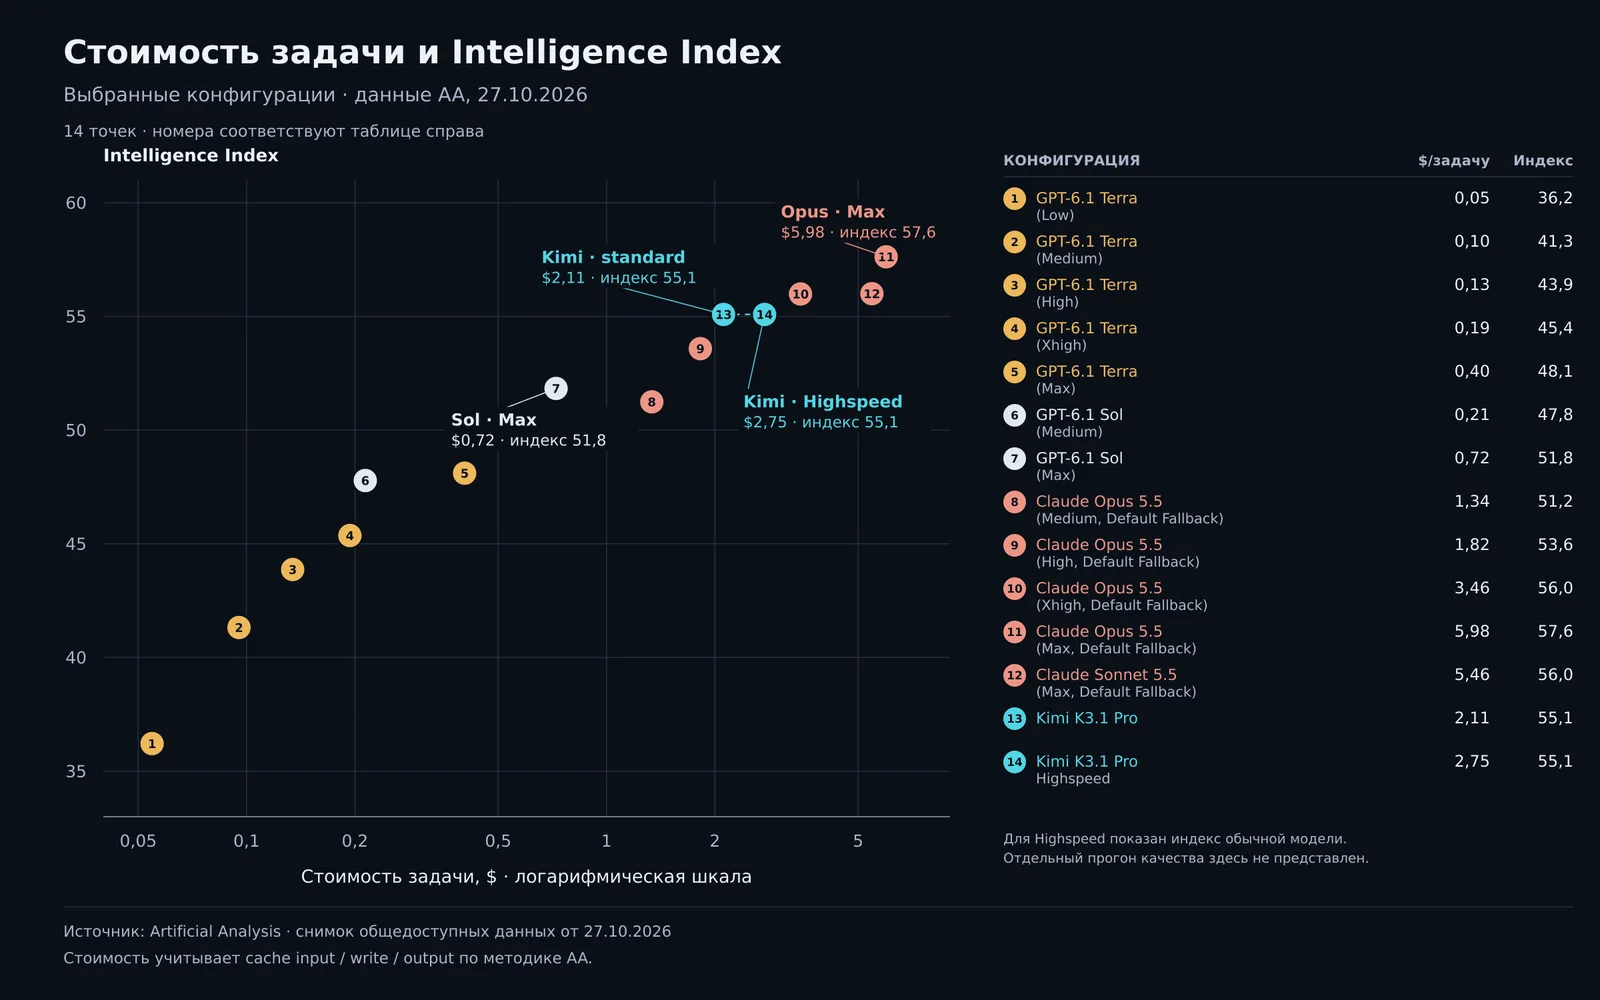
Наш график в полном размере. Исходный скриншот AA сохранён без изменений. Наша тёмная версия построена по проверенным числам страницы AA, а не по приблизительным координатам на скриншоте; значения относятся к моменту чтения страницы.
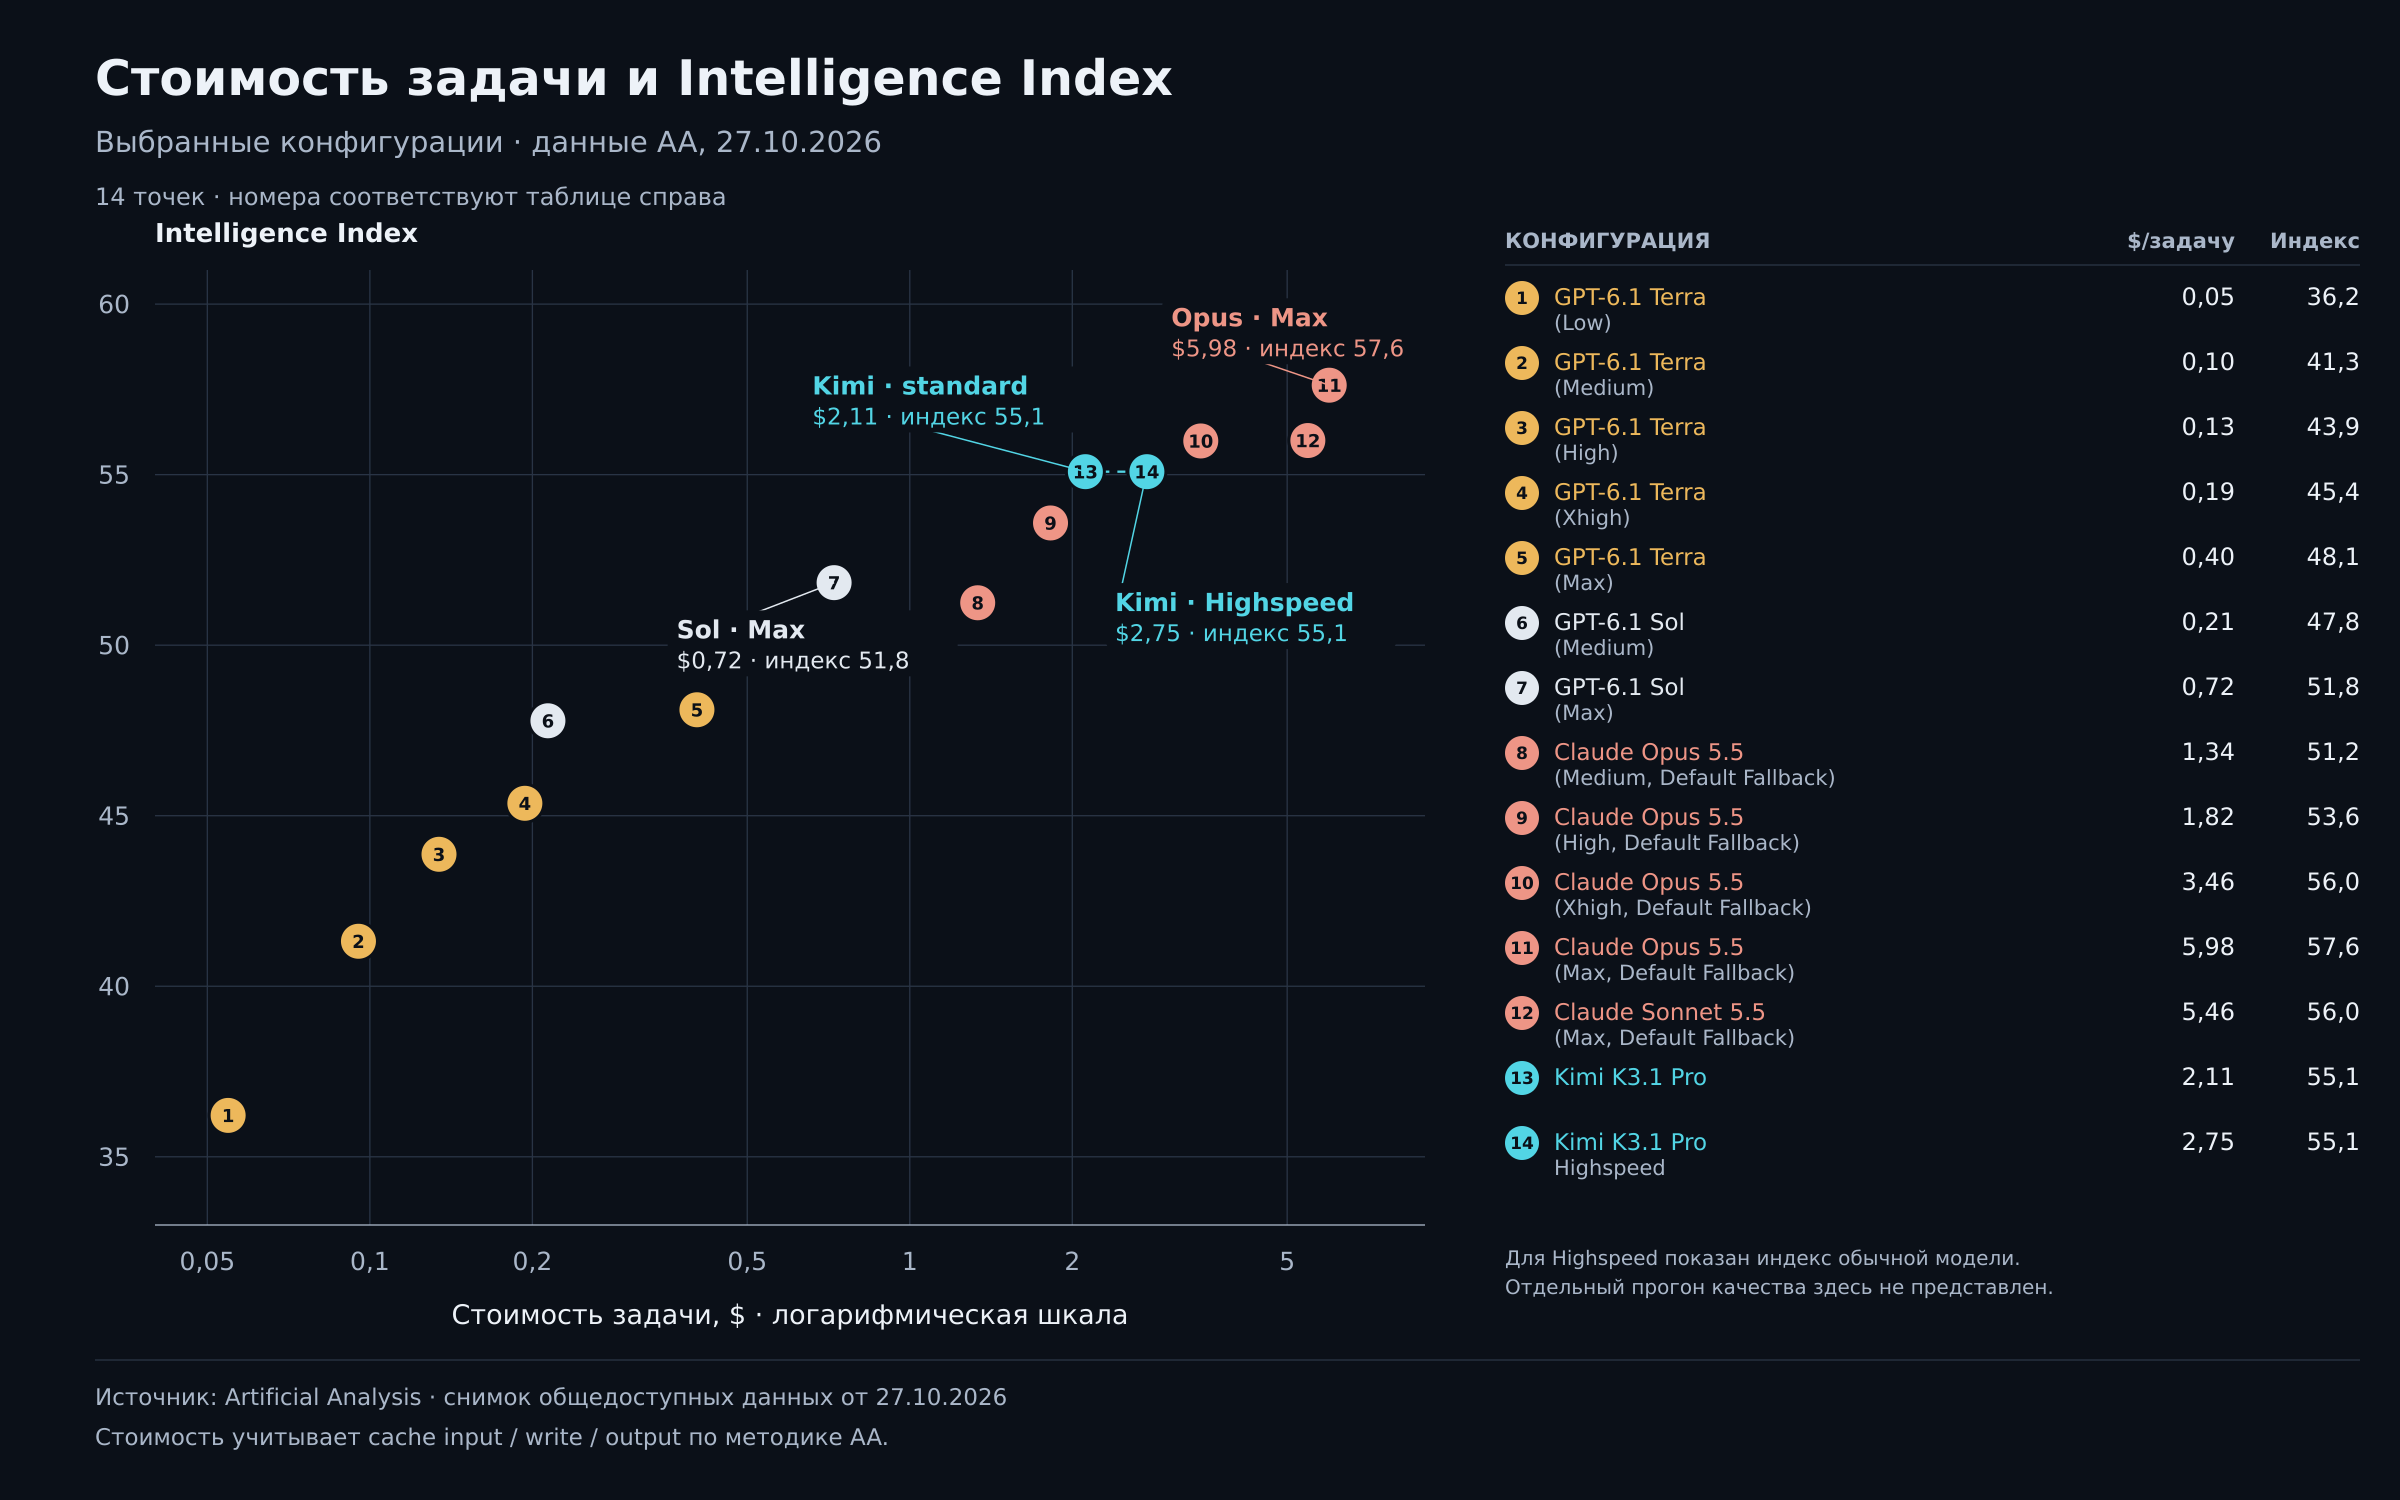
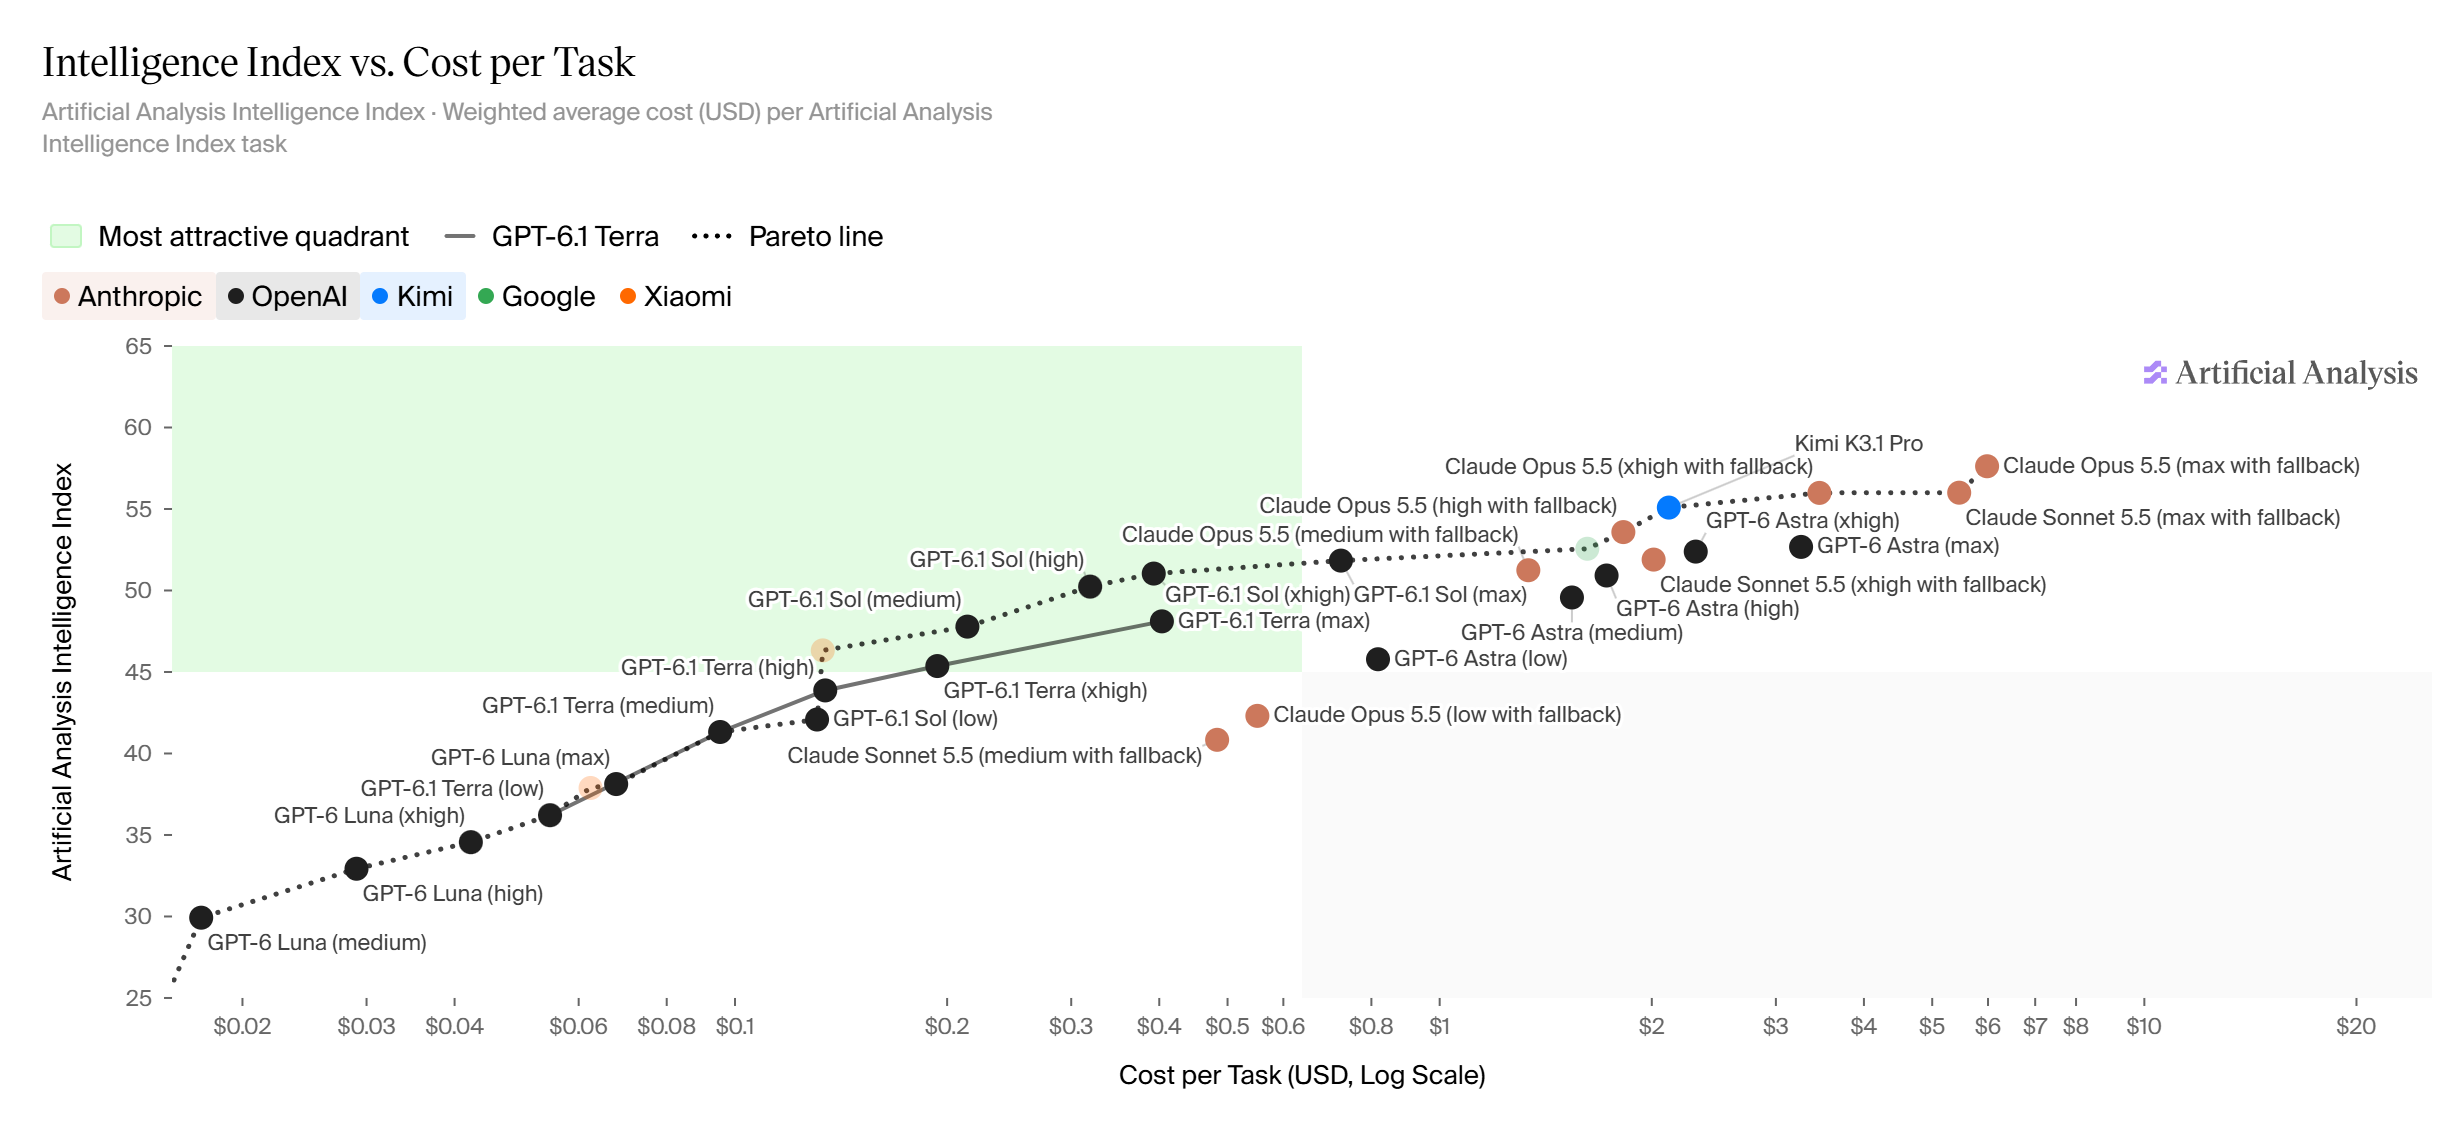
На исходном графике AA пунктирная линия отмечает варианты, для которых среди показанных точек не нашлось одновременно более дешёвой модели с таким же или лучшим баллом. В нашей версии оставлены выбранные модели и режимы, поэтому глобальную границу выгодных вариантов я не дорисовывал. Выше по графику – больше общий балл, левее – меньше стоимость задачи.
Утверждать, что Terra нигде не нужна по цене и качеству, всё-таки нельзя. В своём разборе релиза AA выделяет Low и Medium: они находятся на этой границе выгодных вариантов. High, Xhigh и Max остаются за ней. В отдельном Coding Agent Index картина снова меняется: там на границе находятся Low и Xhigh.
Из режимов Terra мне хотелось бы отдельно попробовать High. Модели Xiaomi на чужом графике выглядят привлекательнее, чем в наших сохранённых прогонах. Поэтому для своей работы я бы оставил Terra среди кандидатов. При этом Low и Medium тоже заслуживают места в сравнении, если задача допускает их уровень качества.
Для сложной текстовой работы пока понятнее взять Sol или подходящую модель Anthropic. А Terra проверить на конкретной нагрузке, где её меньший расход проявится. Режимы одной модели нужно сравнивать отдельно по цене и результату.
MiMo 2.6 Pro мы уже проверяли на русском
У Xiaomi MiMo 2.6 Pro в нашем прогоне 28 сентября получилось 65 баллов за учебные тексты и 66 за симуляцию продаж. Это пять уроков на бизнес-темы и четыре диалога с покупателем, которого играла другая модель. MiMo работала без рассуждений. Эти баллы относятся к нашим рубрикам и напрямую с Intelligence Index не сравниваются.
В уроках проблема была в содержании: модель придумывала кейсы известных компаний и цифры внутри них. Например, в тексте про продажи появился кейс X5 Group с ростом конверсии с 18% до 27%, подтверждения которому при проверке не нашлось. Подробности того же прогона есть в статье о GPT-6 Luna и Sol.
В диалогах Pro получила 83 с техническим директором и 46 с собственником. В последнем сценарии она добавляла не заданные брифом обещания и уступала в цене. Средний балл скрывает этот разброс. Здесь 66 – сырая оценка продаж из опубликованной сводки; после поправки шкалы в лидерборде стоит 81. Это один и тот же прогон, а не два разных результата модели.
Поэтому моё недоверие к Xiaomi опирается на сохранённые ответы и их проверку. Провал MiMo в этих русскоязычных задачах ещё не доказывает преимущество Terra: её предстоит проверить на тех же заданиях.
OpenAI делает ставку на изображения и работу с приложениями
Terra рассчитана на визуальные задачи и управление интерфейсами. В карточке модели OpenAI перечисляет сопоставление фотографий с каталогом, чтение технических чертежей, действия на экране и подготовку текстов. Контекст – 1,05 млн токенов, максимальный вывод – 128 тысяч. Токен здесь – единица текста, которой модель считает объём работы.
В анонсе OpenAI есть и более конкретный аргумент. На Agents’ Last Exam, тесте профессиональных задач с использованием компьютера, компания сообщает о выполнении задач Terra Max более чем втрое быстрее Sol и Astra. Модель доступна в ChatGPT Work и Codex пользователям Plus, Pro, Enterprise и Edu; по заявлению OpenAI, её использование также позволяет выполнить больше задач в пределах того же лимита подписки.
Это измерение разработчика на определённом тесте. Переносить такое ускорение на любое исправление кода я бы не стал. Но и вычёркивать модель по общему баллу было бы преждевременно.
Сам Intelligence Index – преимущественно текстовый англоязычный набор тестов. AA оценивает изображения и многоязычность отдельно. Поэтому общий индекс не закрывает вопрос, насколько Terra подходит для работы с чертежами или экраном приложения. И качество русского текста из него тоже не следует.
Kimi K3.1 Pro обошла OpenAI в общем индексе
Kimi получила 55 баллов Intelligence Index. В разборе Artificial Analysis на момент релиза она занимает четвёртое место, уступая Opus 5.5, Sonnet 5.5 и Muse Wonder Full. Все конфигурации OpenAI на приложенном графике находятся ниже.
Kimi может дать прибавку по качеству к привычному выбору. Особенно заметен скачок в агентном программировании: в прогоне AA результат Terminal-Bench 4.0 вырос с 13% у K3 до 67% у новой модели. Этот тест проверяет выполнение задач в терминале.
У самой Moonshot в релизе указан другой результат того же теста – 65,7%. Это другой прогон и условия, поэтому смешивать эти числа в одну таблицу нельзя. В официальном описании компания также делает акцент на 3D-моделировании, работе с CAD и финансовыми документами. Модель построена на K3 с дополнительным обучением, относится к классу в 3 трлн параметров и поддерживает контекст до миллиона токенов.
Базовые цены входных и выходных токенов обычной Kimi совпадают с ценами Sol. Повторное чтение из кеша у Kimi дороже. Для сравнения ниже – стандартные API-цены за миллион токенов. API означает оплату использования модели в своей программе.
| Модель | Вход | Выход | Повторное чтение из кеша |
|---|---|---|---|
| GPT-6.1 Terra | $1 | $5 | $0,05 |
| GPT-6.1 Sol | $2 | $10 | $0,10 |
| Kimi K3.1 Pro | $2 | $10 | $0,20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0,20 |
Источники: цены OpenAI и официальная платформа Kimi. Для OpenAI здесь приведены цены при входе до 272 тысяч токенов; длинный контекст тарифицируется иначе. Запись кеша и инструменты могут оплачиваться отдельно. Кеш позволяет повторно использовать уже обработанный контекст.
Цена токена не объясняет цену готовой задачи. Модель может дольше рассуждать и писать больше. В разборе релиза AA у Kimi было 1,98 доллара за задачу общего индекса, а при проверке текущей страницы – 2,11 доллара. В обоих срезах она находится далеко правее Sol. Стоимость задачи AA учитывает использование кеша, а эти измерения обновляются. О том, как разделять эти показатели, я писал в статье про сравнение моделей по цене, качеству и скорости.
Почему быстрые токены превращаются в долгую задачу
На исходном скриншоте AA обычная Kimi находится возле 18 минут на задачу. Sol Max – возле девяти, Opus Medium – возле пяти. Даже Opus Max, у которой общий балл выше, находится возле 13 минут. Вот это для меня и есть главная печалька нового релиза: на задачах AA расчётное время декодирования заметно больше, чем у привычных мне моделей.
Откуда у обычной версии эти 18 минут? Я полез смотреть, что именно считает AA. В разборе релиза тестеры прямо пишут: на задачу Intelligence Index у Kimi приходится около 55 тысяч выходных токенов. Это на 14% больше, чем у предыдущей K3.
В сравнении с Sol Max есть разбивка:
| Модель | Весь вывод на задачу | Из него рассуждения |
|---|---|---|
| Kimi K3.1 Pro | 55,2 тысячи токенов | 34,9 тысячи |
| GPT-6.1 Sol Max | 38,1 тысячи токенов | 25,2 тысячи |
Это счётчики API каждой модели. Из-за разных токенизаторов числа нельзя напрямую сравнивать как объём одного и того же текста.
В разбивке AA по тестам у Kimi есть около 144 тысяч выходных токенов на задачу AA-Briefcase и 116 тысяч на задачу Terminal-Bench 4.0. Это агентные задания с несколькими шагами и вызовами модели.
Это взвешенные показатели набора тестов AA, включая агентные задачи с несколькими вызовами. 55 тысяч токенов не означают, что модель пишет такой ответ на каждый вопрос. Но рассуждения здесь занимают около 63% всего вывода Kimi. Они тоже генерируются последовательно и требуют времени, даже если интерфейс их не показывает.
Называть эти токены потраченными впустую я бы не стал: у Kimi и общий балл выше, чем у Sol Max. А Opus Max, например, расходует по счётчикам AA ещё больше – около 119 тысяч токенов на задачу. Вопрос в том, какой результат модель получает за этот объём и сколько приходится ждать.
На странице провайдеров AA при проверке обычная Kimi выдавала 41,4 токена/с, Highspeed – 81,3. Это не те 118–150 токенов/с из отдельных провайдерских проверок на других заданиях. В данных AA большой объём генерации сочетается с невысокой скоростью обычного API.
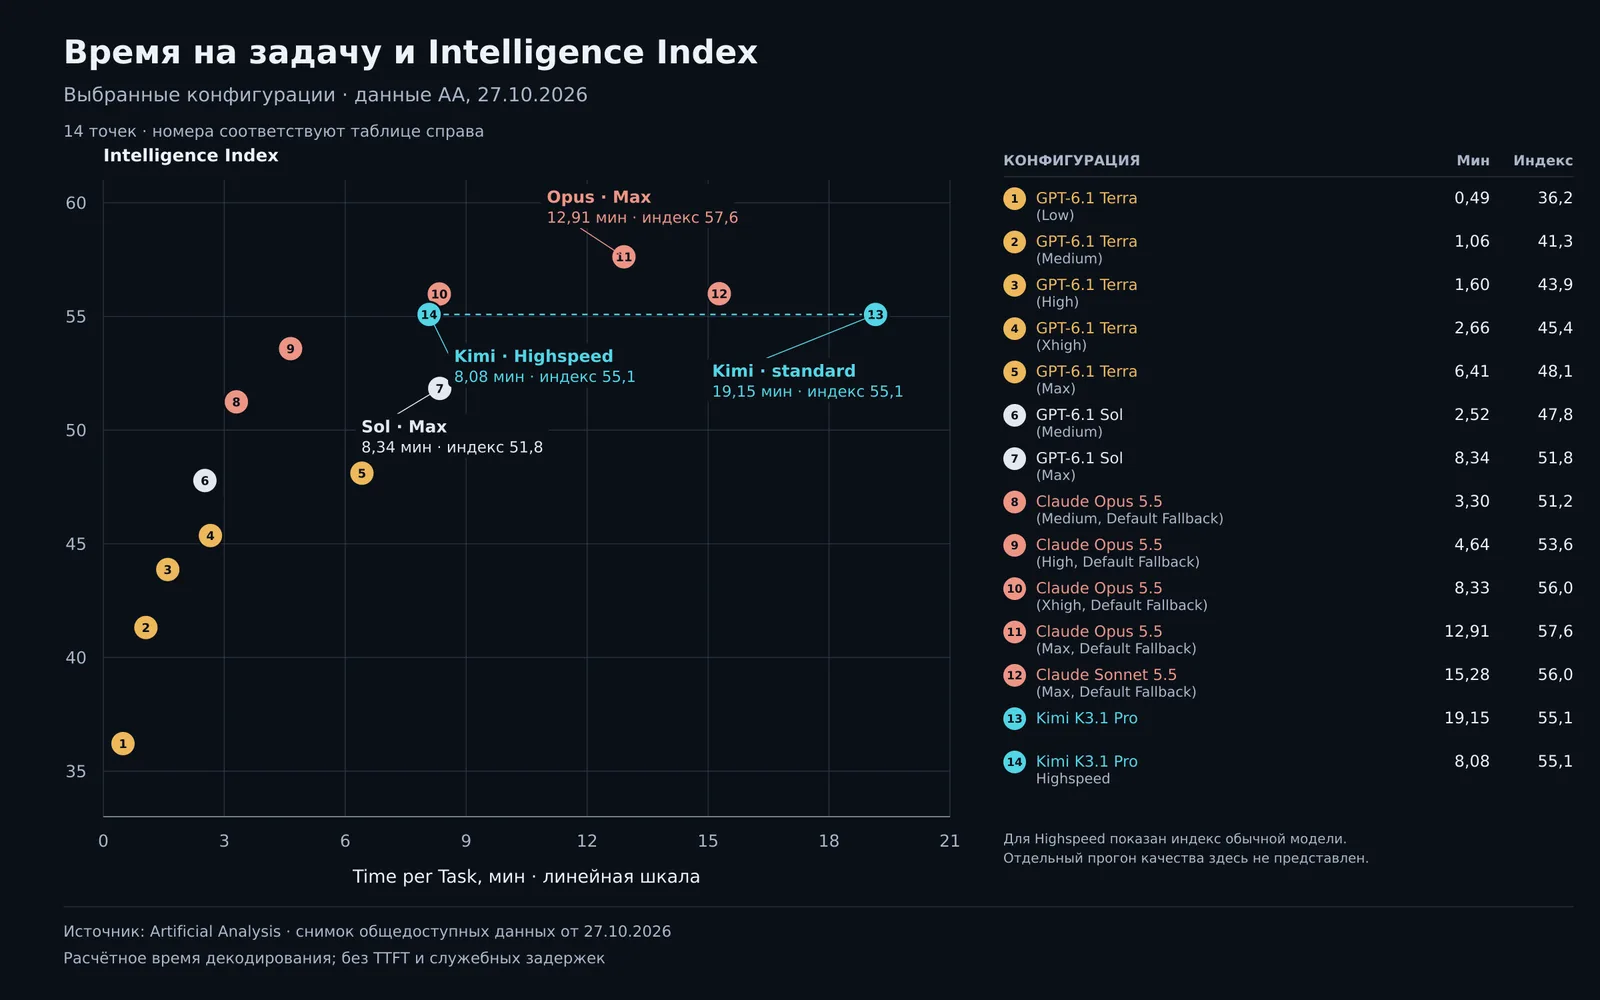
Наш график в полном размере. Исходный скриншот времени AA сохранён без изменений. На нём было около 18 минут у обычной Kimi; в прочитанном позже срезе страницы – 19,2 минуты. Это разные срезы обновляемых данных.
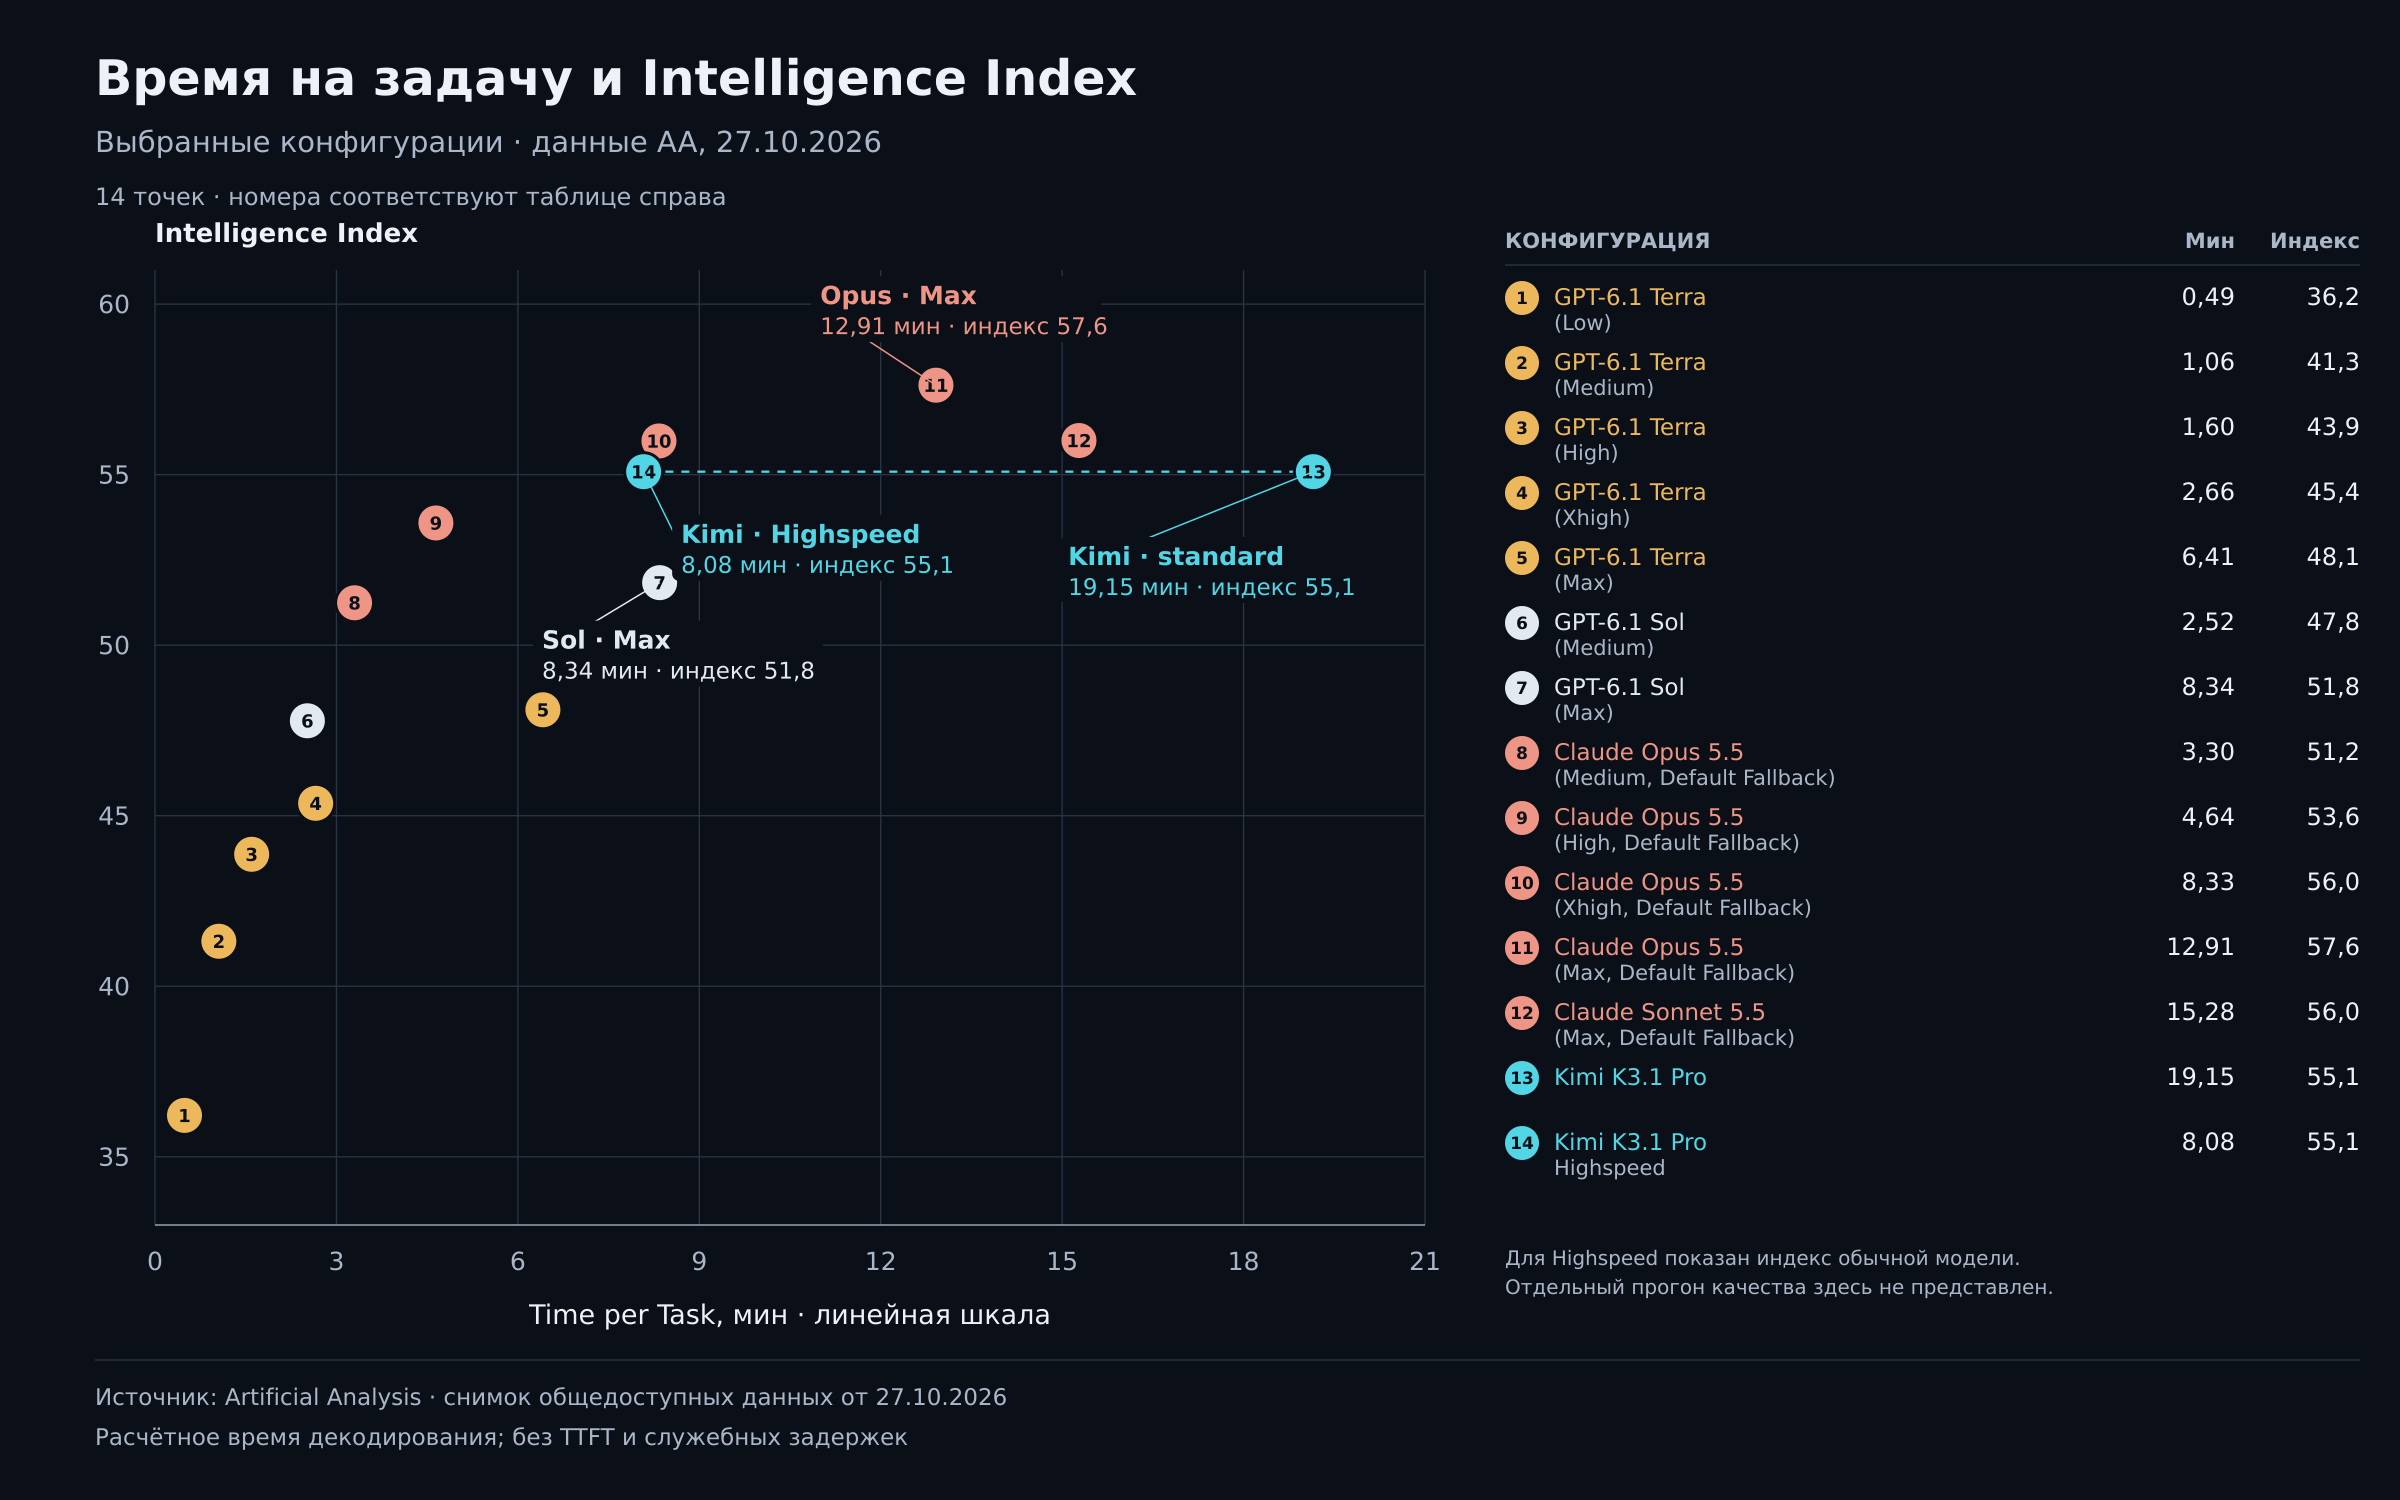
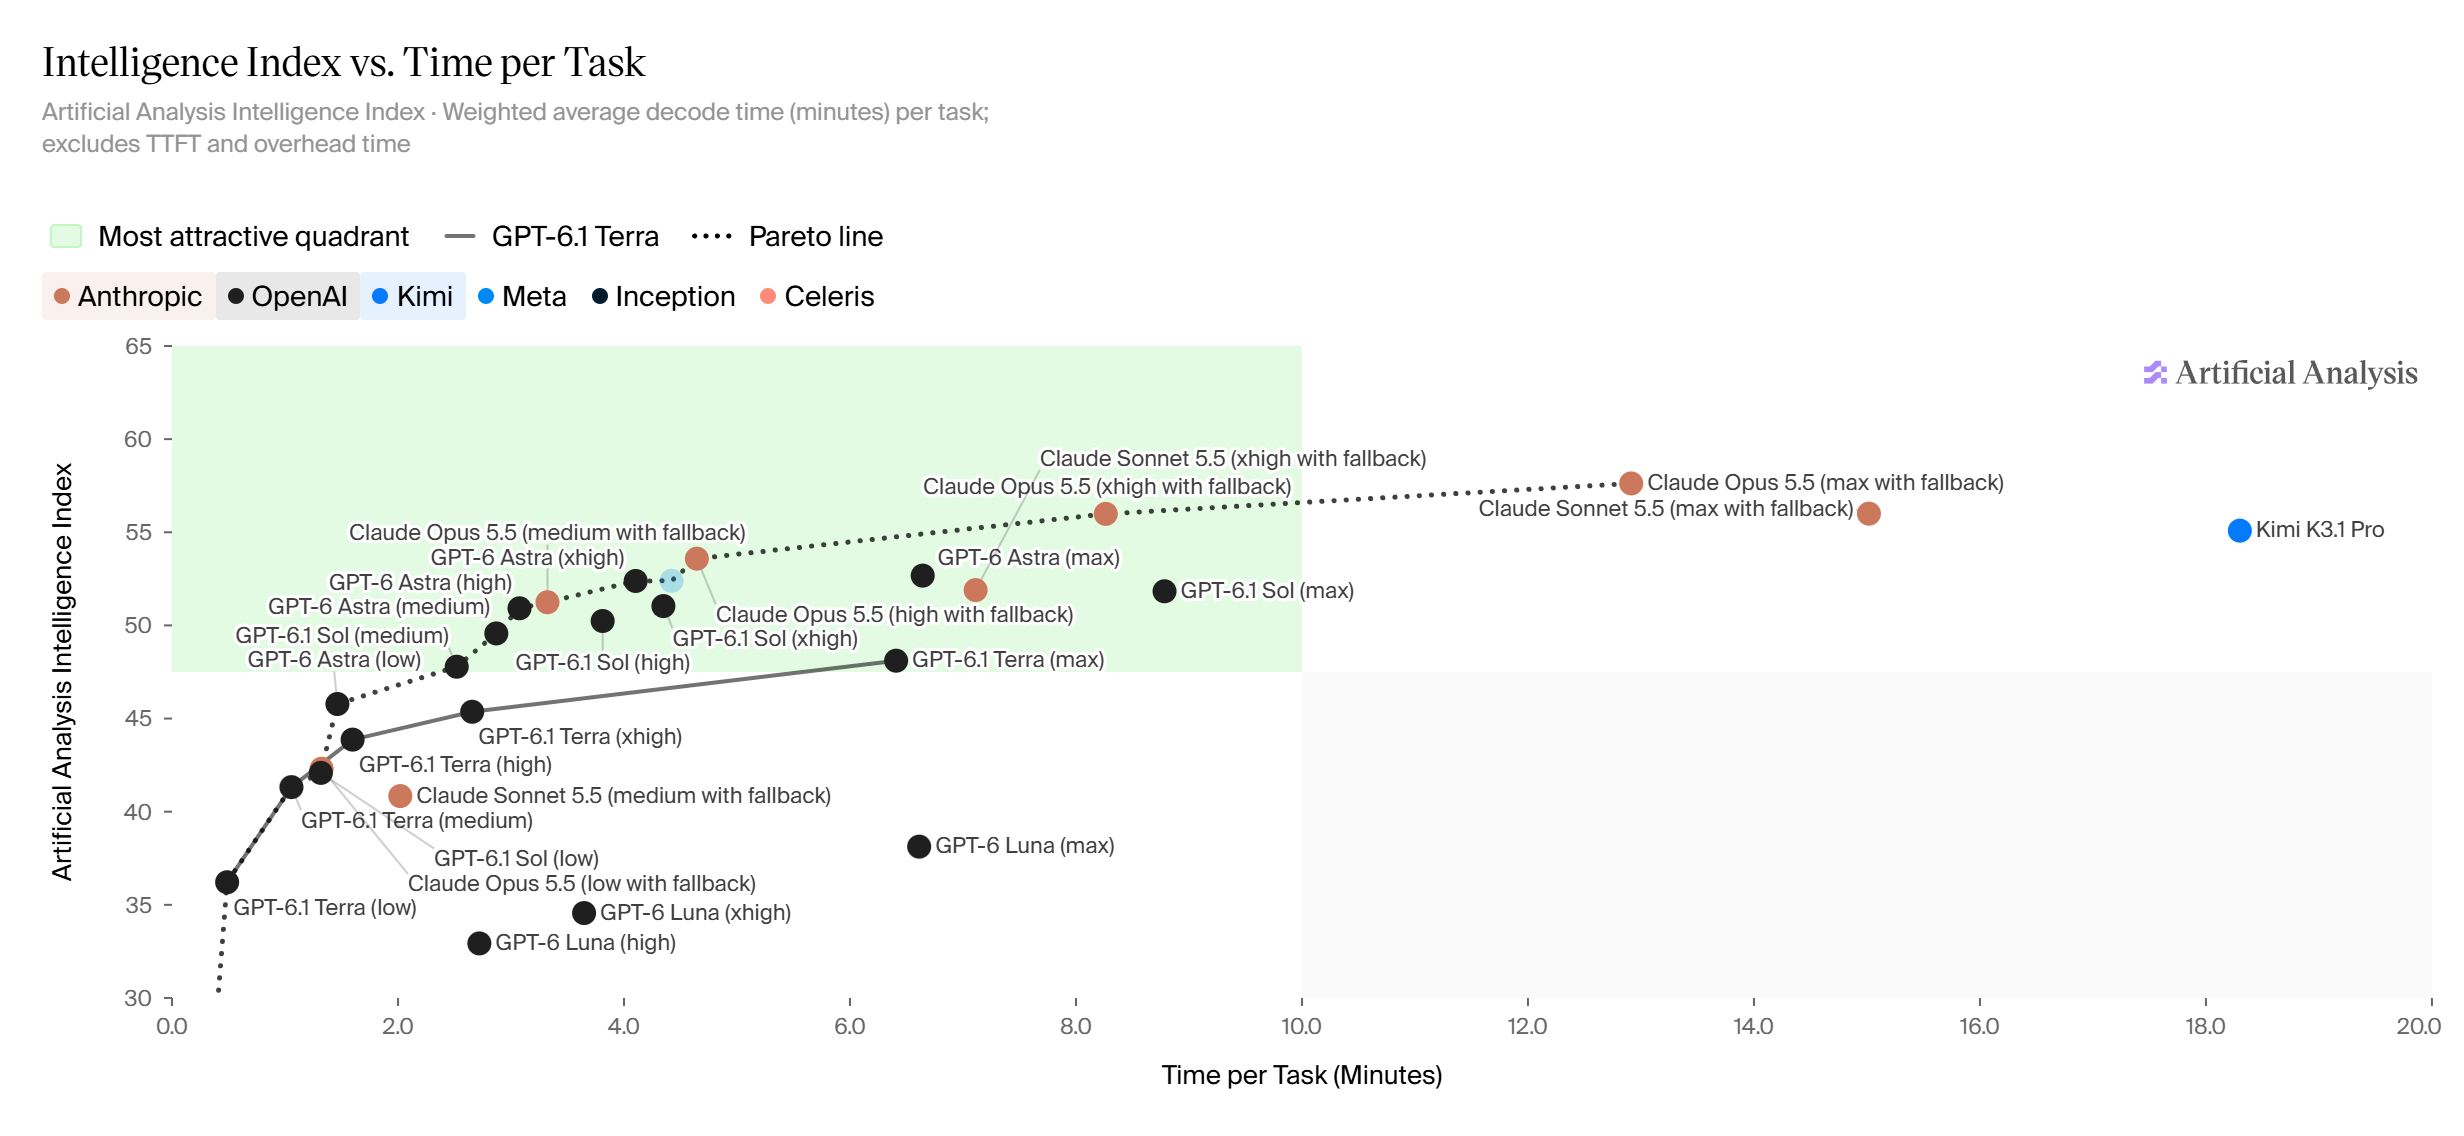
У AA есть точное определение Time per Task. Для каждого теста объём ответа и рассуждений делят на скорость вывода того же API, затем учитывают вес теста в индексе. Это расчётная оценка времени декодирования. Секундомер полного выполнения задачи во время прогона для неё не используют. Ожидание первого токена, инструменты и служебные задержки в этот график не входят.
При этом AA считает токены для индекса по данным API провайдера, а скорость в токенах/с на витрине приводит к общему токенизатору. В расчёте Time per Task используется родной токенизатор модели. Поэтому простое деление 55,2 тысячи на видимые 41,4 токена/с не обязано воспроизвести точку графика. Делить на 150 из чужого теста было бы ещё менее корректно.
Получается, одного обещания ускорить вывод недостаточно, чтобы понять время задачи. В расчёт входят и объём генерации, и скорость конкретного API. Сам график полезен: он показывает, во что эта комбинация обходится на задачах AA. Переносить минуты на любой вопрос в приложении я бы не стал.
Скорость вывода, пауза до начала ответа и полное время задачи различаются. Причины я отдельно разбирал в статье «Почему ИИ-бот долго отвечает».
У Sol и Opus тоже есть ускорение
В двух небольших проверках Highspeed выводила токены быстрее обычной Kimi. Обещанные Moonshot 2–3 раза – тоже сравнение с обычной K3.1 Pro. Само по себе оно не отвечает на вопрос, сколько ждать готового результата. В Kimi Code компания указывает те же способности модели и примерно двойной расход квоты.
24 октября AIHubMix проверил модели через свой API и получил ускорение вывода в 1,6–1,75 раза. Провайдер просил объяснить коллизии хеш-таблиц в 600 словах с коротким примером на Python. Для каждой версии сделали три запуска на Low с лимитом вывода 8192 токена.
| Показатель AIHubMix | Обычная Pro | Highspeed |
|---|---|---|
| Вывод, токенов/с | 85,5–87,6 | 138,1–149,9 |
| Старт рассуждений, с | 3,6–4,5 | 2–3 |
| Старт ответа, с | 71–91 | 40–58 |
| Ответ целиком, с | 80–99 | 43–60 |
Поток рассуждений начинался через несколько секунд. Но до первых слов самого ответа Highspeed тратила 40–58 секунд, даже на Low. В этой серии на рассуждения пришлось 85–90% вывода; один запуск обычной Pro упёрся в лимит токенов. Для короткого диалога я бы такую задержку быстрой не назвал.
Есть и проверка Wokey через Kimi Code от 24 октября: три запуска одного запроса на каждую модель, но уже с High. Провайдер сообщает 118–129 токенов/с у Highspeed против 64–67 у обычной Pro – примерно 1,9 раза. Это другое усилие рассуждения и другой маршрут, поэтому объединять две серии в один бенчмарк нельзя.
Оба источника продают доступ к моделям; это их небольшие проверки, а не наш замер или гарантия скорости подписки. Задания отличаются от AA, а одинаковые настройки и подсчёт токенов в этих источниках не подтверждены. Но после этих цифр Highspeed для меня звучит скромнее: прибавка есть, а ожидание содержательного ответа остаётся. Рассуждения тоже входят в вывод модели и ускоряются вместе с текстом ответа.
Сравнивать ускоренную Kimi только с обычными конкурентами недостаточно. У Sol есть Fast и Ultrafast. А у Opus 5.5 есть Fast mode: Anthropic обещает до 2,5 раза быстрее выводить токены при тех же способностях модели. Это не обещание такого же сокращения паузы до первого токена.
Для основного сравнения теперь можно взять Kimi и конкурентов у одного тестера. Ниже – скорости из прочитанных карточек AA на 27 октября. Они измерены в API; одинаковая методика скорости не делает одинаковыми усилие рассуждения и качество моделей.
| Модель и режим | Вывод, токенов/с | Источник |
|---|---|---|
| Kimi K3.1 Pro, обычный API | 41,4 | AA, Kimi |
| Kimi K3.1 Pro, Highspeed | 81,3 | AA, Kimi High Speed |
| GPT-6.1 Sol Medium, обычный API | 53,5 | AA, семейство Sol |
| GPT-6.1 Sol Max, обычный API | 74 | AA, стандартный OpenAI |
| GPT-6.1 Sol Max, Fast | 131,2 | AA, OpenAI Fast |
| GPT-6.1 Sol Max, Ultrafast | 326,2 | AA, OpenAI Ultrafast |
| Claude Opus 5.5 Max с fallback, обычный API | 98,3 | AA, Opus |
| Claude Opus 5.5, Fast | Нет замера в этой таблице AA | Anthropic: обещание до 2,5 раза к обычному выводу |
| Claude Sonnet 5.5 Max с fallback, обычный API | 141,2 | AA, Sonnet |
В этом срезе AA Highspeed по темпу вывода ближе к обычной Sol Max. До Sol Fast и Ultrafast ей заметно дальше. Показатели 118–150 из двух малых проверок остаются результатами тех проверок; сравнивать по ним лидерство среди моделей я бы не стал.
Ускорение оплачивается и у конкурентов. По официальным API-ценам OpenAI Sol Fast стоит $4 за миллион входных и $20 за миллион выходных токенов, Ultrafast – $12 и $60 при входе до 272 тысяч токенов. У Opus 5.5 Fast – $8 и $40 против обычных $4 и $20. Это API-тарифы; скорости из таблицы не гарантируют такой же темп в приложении по подписке.
Для времени задачи тоже нашлись данные самого AA. При чтении страницы у обычной Kimi была оценка 19,2 минуты, у Highspeed – 8,1 минуты. У обычной Sol Max в том же наборе данных – 8,3 минуты. Эти числа взяты из данных страницы AA; самостоятельно умножать старые 18 минут на ускорение из другого теста теперь не требуется.
Получается, Highspeed заметно улучшает положение Kimi: расчётное время уже близко к обычной Sol Max. Общий балл AA для той же модели Kimi выше; отдельного прогона качества Highspeed в этих данных нет. Но сравнение по темпу вывода с ускоренными Sol остаётся в пользу Sol. А результат на задачах AA ещё не говорит, сколько законченных задач даст моя подписка с её ограничениями.
В документации Kimi Code доступ разделён так:
| Подписка | Обычная K3.1 Pro | Highspeed | Контекст K3.1 Pro |
|---|---|---|---|
| Plus / прежний Moderato | Доступна | Недоступен | До 256 тысяч токенов |
| Pro / прежний Allegretto и выше | Доступна | Доступен | До миллиона токенов |
Wokey измерил скорость вывода через Kimi Code, но результата на наших задачах по подписке пока нет. Рассчитанные AA минуты не обещают такого же времени в приложении: там добавятся инструменты, очереди и скрипты. Опубликованные серии не воспроизводят наш рабочий процесс.
Подписка также ограничена квотой. По официальным условиям, у новых тарифов есть скользящее пятичасовое окно и месячный объём. Недельное ограничение для них убрали; у старых тарифов сохранились прежние правила. Использование в разных клиентах учитывается совместно. Для меня поэтому вопрос звучит так: сколько законченных задач даст Highspeed до исчерпания доступного лимита?
С настройками по умолчанию есть путаница: страница моделей Kimi Code указывает High, а обзорная страница – Max. У публичного API тоже указан Max. Для будущего сравнения я бы явно задал одинаковое усилие рассуждения в обоих клиентах.
Открытые веса дают Kimi шанс измениться после релиза
Moonshot обещает выложить полные веса к 4 ноября 2026 года. На дату этого текста, 27 октября, это ещё предстоящий выпуск. Веса – файлы, с которыми модель можно запускать на своей инфраструктуре; условия такого запуска определяет лицензия.
Открытость для меня даёт Kimi много дополнительных очков. Хочется, чтобы такую модель могли использовать разные команды, а за её запуск конкурировали провайдеры. Есть надежда на более быстрые и дешёвые варианты исполнения.
Но пока корректно говорить об обещанных открытых весах. Доступность скачивания и финальные условия лицензии предстоит проверить при выпуске. И сам факт публикации не гарантирует ускорения: потребуются подходящее оборудование и программная часть для запуска модели. Сроков и будущих цен у независимых провайдеров сейчас из этого обещания не вывести.
Поэтому Kimi меня интересует и как сегодняшняя модель, и как кандидат, к которому стоит вернуться после открытия весов.
Пока я бы проверял две разные гипотезы
Terra имеет смысл пробовать там, где подходят Low/Medium, нужен меньший расход лимита или есть работа с изображениями и интерфейсами. Для сложной текстовой работы её Max пока не даёт мне понятной причины уходить с Sol. High я бы оставил отдельным кандидатом: результаты нашего теста MiMo показывают, почему одной точки Xiaomi на общем графике мне недостаточно.
У Kimi долгое время объясняется и объёмом генерации, и скоростью API. Highspeed помогает: в прочитанном срезе AA её расчётное время – 8,1 минуты против 19,2 у обычной версии, близко к обычной Sol Max. Но при сравнении ускоренных режимов у Sol темп вывода выше. При примерно двойном расходе квоты Kimi Code мне всё ещё интересно проверить, сколько своей работы я успею закончить по подписке. Открытые веса дают повод вернуться к этому вопросу после релиза.
Общий рейтинг помогает выбрать кандидатов, но дальше я хочу получить результат на своей работе. Для такого выбора есть Model Compass и статья о том, как выбрать LLM для проекта. Данные Compass имеют собственную дату среза: наличие там новинок нужно проверять отдельно.
В Telegram-канале можно обсудить практический опыт с этими моделями. Особенно интересен Kimi Code Highspeed: меня пока останавливает именно сочетание ожидания и расхода квоты. Открытые веса добавляют надежды, а вот желания платить за модель по одному месту в рейтинге у меня так и не появилось.