
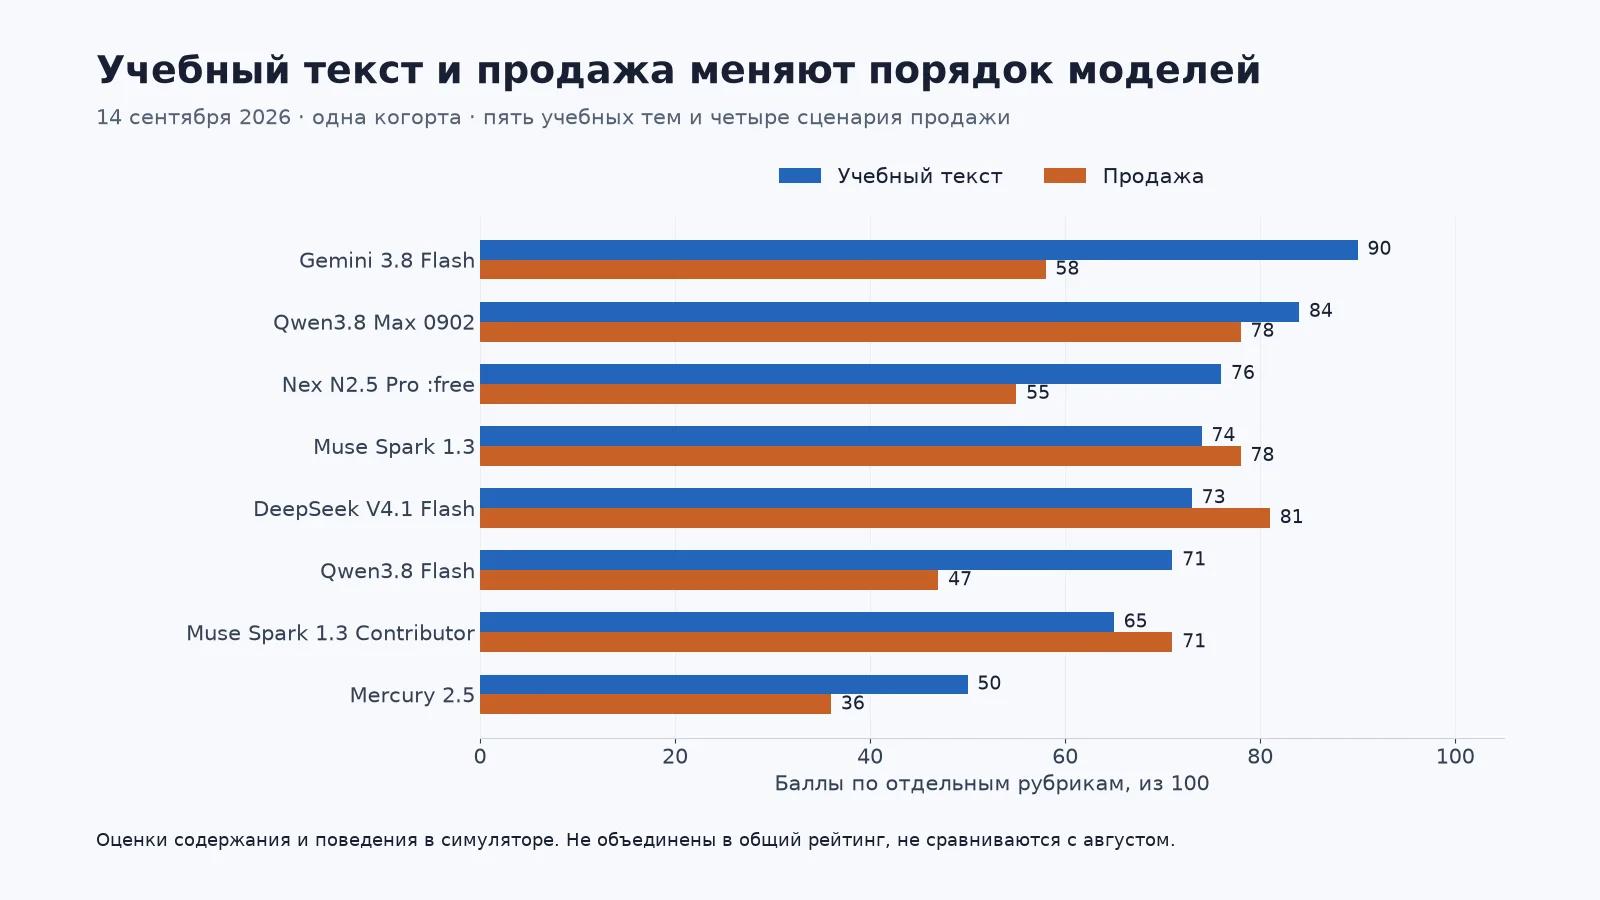
Тест языковой модели под задачу меняет порядок кандидатов. 14 сентября Gemini 3.8 Flash получила 90 баллов за русские учебные тексты и 58 за продажи; DeepSeek V4.1 Flash — 73 и 81. Если сравнить эти две конфигурации, первая сильнее на уроках, вторая — в диалогах. В той же волне контрольный alias набрал 92 и 80, но его стабильную версию установить не удалось.
Я провёл три волны: 1, 14 и 28 сентября. Между ними менялись состав моделей, режимы запуска и сценарии. Поэтому эти результаты помогают выбрать, что проверять у себя, но не складываются в общий рейтинг.
Тест языковой модели под задачу должен воспроизводить рабочие ошибки
Я разделил проверку на учебный текст и продажный разговор. В первом случае модель готовила по одному уроку на русском для каждой из пяти тем: продажи, финансы, цепочки поставок, ценообразование и персонал. Во втором другая языковая модель играла финдиректора, технического директора, закупщика или собственника.
Продажный блок состоял из четырёх диалогов. Покупатель задавал вопросы по брифу, а продавец должен был выяснить потребность и предложить следующий шаг. Реальные встречи, сделки и результаты обучения в тесте не измерялись.
У обеих рубрик базовая сумма — 100 баллов, но критерии и их веса разные. Для урока это содержание — 35, практическая польза — 25, выполнение задания — 15, отсутствие выдумок — 10, структура — 10 и визуализация — 5. Для продаж: возражения — 25, выявление потребности — 20, методика, честность и следующий шаг — по 15, тон — 10.
В обеих шкалах есть бонусы и штрафы, поэтому результат может быть выше 100. Это баллы разных рубрик, не проценты удачных уроков или продаж. Их нельзя усреднить в одну оценку.
Оценки ставил LLM-судья. В исследовании MT-Bench и Chatbot Arena описаны возможные смещения таких судей: к длине ответа, его позиции и собственному семейству модели. Эта работа не проверяла наши прогоны, поэтому я читаю баллы вместе с самими ответами.
Сентябрьские оценки расходились между задачами
Таблицы показывают сохранённые результаты каждой волны, а не общий рейтинг. Стоимость — историческое фактическое списание за диалог в том прогоне, не текущая цена.
1 сентября
| Конфигурация | Уроки, баллы | Продажи, баллы | Диалог, $ |
|---|---|---|---|
| HY4 Preview | 80 | 89 | 0,00812 |
Ling 3.0 Flash Fin :free |
68 | 58 | н/д |
| Granite 4.2 8B | 40 | 33 | 0,00446 |
Для Ling в сводке был расчётный ноль, но фактического списания за продажный диалог в метаданных нет. Поэтому здесь н/д. По учебному вызову ноль, напротив, был записан фактически.
На уроках Granite обошлась в $0,00194 против $0,01133 у HY4 Preview. Оценки составили 40 и 80. Я сначала смотрю, можно ли использовать результат, и только потом считаю экономию на его генерации.
14 сентября
| Конфигурация | Уроки, баллы | Продажи, баллы | Диалог, $ |
|---|---|---|---|
| DeepSeek V4.1 Flash | 73 | 81 | 0,00512 |
| Gemini 3.8 Flash | 90 | 58 | 0,03470 |
| Mercury 2.5 | 50 | 36 | 0,00064 |
| Muse Spark 1.3 | 74 | 78 | 0,05334 |
| Muse Spark 1.3 Contributor | 65 | 71 | 0,00286 |
Nex N2.5 Pro :free |
76 | 55 | н/д |
| Qwen 3.8 Flash | 71 | 47 | 0,00142 |
| Qwen 3.8 Max 0902 | 84 | 78 | 0,08264 |
~openai/gpt-luna-latest, контроль |
92 | 80 | 0,00288 |
Gemini объяснила техническую архитектуру, но назвала не указанные в брифе пилоты и статистику ошибок. В диалоге с финдиректором она добавила неподтверждённый кейс про каталог на 12 тысяч SKU. Высокий балл за урок не исправляет такую ошибку в продажах.
Mercury ответила по своей метрике за 12 секунд и стоила $0,00064 за диалог. При этом она пообещала владельцу мебельного бизнеса окупаемость за один-два месяца и рост спроса на 30–40%, которых в брифе не было. Время продавца в этой волне — сумма ожиданий его ответов, без вызовов модели-покупателя; это не задержка одной реплики.
У контрольного ~openai/gpt-luna-latest точная стабильная версия по артефактам не установлена. Само слово «контроль» в строке не превращает её в неизменную линейку для всех сентябрьских волн.
28 сентября
| Конфигурация | Уроки, баллы | Продажи, баллы | Диалог, $ |
|---|---|---|---|
| MiMo 2.6 Flash | 77 | 59 | 0,00142 |
| MiMo 2.6 Pro | 65 | 66 | 0,00456 |
| DeepSeek V4.1 Flash | 76 | 57 | 0,00276 |
| Qwen 3.8 Omni Flash | 70 | 37 | 0,00182 |
| Space Bunny Alpha | 72 | 50 | н/д |
MiMo 2.6 Pro получила за уроки 65 баллов против 77 у Flash, а за продажи — 66 против 59. У Pro отдельные диалоги тоже разошлись: 83 с техническим директором и 46 с собственником. Среднее 66 не показывает, где продавец удержал разговор, а где покупатель его остановил.
Space Bunny Alpha получила 72 за учебную конфигурацию с режимом low. В дополнительном запуске с настройками провайдера по умолчанию четыре из пяти ответов были пустыми с finish_reason: length, а пятый оборвался. Это другой запуск; пустые ответы не входят в 72 балла. В тесте продаж использовался режим провайдера по умолчанию, поэтому это сравнение сохранённых конфигураций, а не одинаковых настроек двух задач. Продажное списание Space Bunny тоже отсутствует, поэтому стоимость отмечена как н/д.
Повторный тест помогает заметить изменение, но не доказывает деградацию
Я возвращаюсь к ключевым моделям, чтобы проверить, сохранилось ли качество. Но разница между двумя волнами сама по себе ничего не доказывает, если поменялись сценарии или настройки.
DeepSeek V4.1 Flash получила 81 за продажи 14 сентября и 57 — 28-го. В последней волне она набрала 81 с техническим директором и 46 с закупщиком; в заметках последнего прогона ранний покупатель назван более мягким. Состав четырёх ролей оставался тем же. Я не называю эту разницу деградацией модели.
Для повторной проверки нужно сохранить идентификатор и версию модели, текст заданий, роли собеседника, параметры запуска и версию рубрики. Полезно повторять и одну известную конфигурацию: без неё сложно понять, изменилась модель или сама линейка оценки.
Настройки тоже входят в цену и результат. В OpenRouter по видимому ответу нельзя понять, включён ли режим рассуждений: документация отдельно описывает, как токены рассуждений учитываются в выходных токенах. А классы обслуживания нужно записывать рядом с конфигурацией. Спрятанное рассуждение и отключённое — разные настройки.
Как использовать тест для выбора модели
Выбор модели для бизнеса начинается с задач и цены ошибки. Поэтому тест языковой модели под задачу я читаю в таком порядке:
- Сначала смотрю, выдерживает ли кандидат нужный сценарий: пишет ли урок без выдуманных цифр, удерживает ли условия в диалоге и отвечает ли на возражение по брифу.
- Затем читаю слабые отдельные ответы. В продажах среднее может скрыть разницу между техническим директором и закупщиком; в учебном тексте надо проверить расчёты и упражнения.
- После этого сравниваю время и фактическое списание. Историческая цена помогает понять прошлый запуск, но не заменяет текущий тариф провайдера.
- При обновлении модели или маршрута повторяю тот же набор условий. Иначе новое число нельзя честно сравнить со старым.
Общий подход к выбору LLM для проекта разобран в отдельной статье. Как меняется счёт на одном и том же маршруте, я показывал в разборе расходов на LLM. Полные текущие результаты находятся в разделе бенчмарков; августовские и сентябрьские суммы в этой статье — история отдельных прогонов.
Что эти оценки не доказывают
Пять уроков и четыре диалога — небольшая выборка. Балл судьи не доказывает, что ученик усвоил материал или реальный покупатель согласился на встречу. Ни обучение, ни конверсию я здесь не измерял.
Судья может предпочитать длинный ответ или свою модель, а состав участников и запуск менялись. Поэтому я не вывожу из таблиц универсального победителя месяца и не объявляю падение между несопоставимыми волнами деградацией. Даже удобный рейтинг требует чтения ответов.
Отдельный разбор того, как устроена проверка LLM-судьёй полезен для контекста, но не валидирует сентябрьские оценки. Эти результаты отвечают только на более узкий вопрос: что получилось у сохранённых конфигураций в двух русскоязычных задачах.
Новые статьи и разборы я собираю в Telegram-канале; текущие измерения можно открыть на странице бенчмарков.