
На сайте появилась Model Compass – страница, где можно подобрать модель для своей работы. Передо мной давно стоит вопрос: какую модель использовать и для чего? Для короткого ответа, работы с документами и программирования требования разные. А модель вверху общего рейтинга ещё нужно проверить на своей задаче.
Я собрал сравнение моделей по цене, качеству и скорости. Можно выбрать OpenAI, Anthropic или обе компании, указать свою деятельность и посмотреть рекомендации. Для программирования отдельно предусмотрел работу одной моделью и связку с оркестратором и воркерами.
В основу положил таблицу Model_selection_analysis.xlsx с показателями Artificial Analysis. В первой версии 25 конфигураций шести семейств: учитывается и модель, и усилие рассуждения. Это готовые API-замеры из переданной таблицы. Она импортирована 30 сентября 2026 года; дата самих измерений в исходнике не указана.
Скачать исходную таблицу (XLSX, 45 КБ).
Качество зависит от того, какую работу вы поручаете модели
Начинать на странице нужно с поля «Деятельность». Оно выбирает профиль качества, по которому Compass подбирает кандидатов. Для программирования используются результаты Terminal-Bench, для работы с PDF – GDP.pdf, для длинных материалов – AA-LCR. Названия тестов и пояснения видны на странице.
| Что вы делаете | На какой результат смотрит Compass | Что он помогает оценить |
|---|---|---|
| Программируете | Terminal-Bench | Выполнение задач с кодом и терминалом |
| Готовите деловые материалы и отчёты | AA-Briefcase | Качество решения задач с рабочими материалами |
| Работаете с PDF | GDP.pdf | Ответы с опорой на большой документ |
| Разбираете длинный контекст | AA-LCR | Поиск ответа в длинных материалах |
Общий Intelligence Index – сводный показатель. В методике AA он описан как объединение нескольких тестов с ограничениями применимости. На странице он служит ориентиром для повседневной работы, текстов и быстрого чата: отдельных замеров русского стиля или переводов в этой таблице нет.
У тестов разные шкалы. Где-то результат выражен в процентах, где-то в пунктах, а в деловых задачах используется Elo – сравнительный рейтинг качества работ. Разница в 100 Elo не означает, что модель делает на 100 процентов больше хороших отчётов. Сравнивать числа нужно внутри одного теста.
Для меня бенчмарк здесь сокращает список кандидатов. Если выбираете модель для своих документов, следующий шаг – дать ей эти документы и проверить ответы, ссылки и пропуски. Работа с конкретным PDF может отличаться от задачи, по которой получен балл.
Сравнение моделей по цене: подписка и API
В режиме «Моя подписка» Compass учитывает уже имеющийся доступ. Выбираете компанию, тариф и приложение, в котором работаете. Для OpenAI это, например, ChatGPT, приложение Codex или терминал. Для Anthropic – веб-чат и приложение Claude, Cowork, варианты Claude Code, включая терминал.
Если пользуетесь обеими компаниями, рекомендации показаны отдельно для OpenAI и Anthropic. Можно посмотреть варианты для каждого своего доступа и решить, куда отдать задачу.
Режим API нужен для сравнения моделей при оплате использования. Цена здесь взята из исходной таблицы и относится к тестовой задаче AA. Это исторический показатель: свой запрос будет стоить иначе в зависимости от объёма текста, рассуждений и других условий.
На оси цены в подписке указаны доллары в месяц, в API – доллары за тестовую задачу. Эти единицы нельзя смешивать. Если подписка уже оплачена, её месячная цена также не равна стоимости следующего сообщения. Страница показывает доступные варианты, но остаток вашего лимита не рассчитывает.
Быстрый старт и быстрая генерация – разные вещи
Для чата имеет значение, сколько вы ждёте начала ответа. Для длинного текста – ещё и то, как быстро модель его пишет. На карте можно переключать показатель скорости и сравнивать модели по нужному вам критерию.
| Показатель на странице | Как его читать |
|---|---|
| Первый содержательный токен | Пауза до начала ответа в секундах. Меньше – раньше увидите содержательный текст |
| Скорость генерации | Токены в секунду после старта. Больше – быстрее идёт текст. Токен – часть текста, он не всегда равен слову |
| Время ответа · 500 токенов | Расчётное ожидание ответа заданной длины с учётом старта и генерации. Меньше – быстрее |
| Декодирование задачи AA | Время генерации для другой тестовой нагрузки. Сравнивается отдельно от ответа на 500 токенов |
Высокая скорость генерации может соседствовать с долгим ожиданием старта. Поэтому я бы сначала посмотрел на первый содержательный токен для короткого чата, а для ответа целиком – на расчётные 500 токенов. Для фоновой работы допустимое ожидание можно увеличить.
Эти секунды не описывают полное время, за которое агент исправит ошибку в репозитории. В программировании добавятся чтение файлов, инструменты, тесты и повторные попытки. Да и API-замеры служат только приближением для поведения ChatGPT, Codex или Claude в приложении. О других причинах задержек я писал в статье «Почему ИИ-бот долго отвечает».
Одна модель, разные усилия рассуждения
Усилие, или effort, задаёт интенсивность рассуждения модели. Low и Medium считаются разными конфигурациями. В таблице из первой версии страницы для GPT 6.1 Sol получается такое сравнение:
| Конфигурация | Intelligence Index, пункты | API-цена тестовой задачи из таблицы | Расчётное время ответа на 500 токенов |
|---|---|---|---|
| Sol 6.1 · Low | 42 | $0,13 | 9,43 с |
| Sol 6.1 · Medium | 48 | $0,21 | 14,13 с |
Medium набирает на шесть пунктов больше, при этом растут цена и ожидание. Пункты индекса здесь не означают процент успеха на вашей работе. И цена в этой таблице относится к тестовой задаче: это не стоимость соседнего ответа на 500 токенов.
Из такого сравнения видно, за что платите и чего ждёте. Для задачи, где Low даёт достаточный результат, переход на Medium ещё нужно обосновать. Для более сложной задачи дополнительные пункты могут оказаться полезными – это проверяется на ней самой.
Для программирования можно выбрать одну модель или команду
«Без оркестрации» означает, что вы работаете с одной моделью в конкретной задаче. Это не мешает переключать её между задачами. В режиме подписки Compass показывает ориентиры для обычной работы, простых поручений и сложных задач.
При выборе «Оркестрация» появляются рекомендации по ролям. Оркестратор разбирает задачу, составляет план, распределяет работу и проверяет общий результат. Воркер выполняет ограниченное поручение: правку, тест, поиск места ошибки. В настройках можно указать желаемые модели для этих ролей.
Переключатель влияет на рекомендации, а измеренные баллы моделей остаются прежними. Иногда одна конфигурация подходит сразу для оркестратора и воркера – особенно при выбранных API-ограничениях. Если желаемая модель не проходит по доступу или порогам, Compass показывает предупреждение и доступные варианты.
Рекомендации по ролям – стартовая схема распределения работы. Из исходной таблицы нельзя узнать, сколько исправлений сделает ваша команда агентов. Я бы начал с небольшого поручения с понятным результатом и проверил исполнителя до передачи ему большой части проекта.
Как пользоваться 3D-картой
На карте каждая точка – конфигурация модели. Ось X показывает цену, Y – качество по выбранному тесту, Z – скорость. Такой график называется трёхмерной диаграммой рассеяния; на странице я называю его 3D-картой.
- Выберите «Моя подписка» или API, компанию и деятельность. Для подписки укажите свой доступ, для API при необходимости задайте пороги качества и ожидания.
- Карта видна сразу под вступлением, а подбор и рекомендации находятся ниже. Над картой можно переключить Sol / Opus, тест качества и показатель скорости. Пока тариф не указан, карта показывает явно обозначенный обзор API-замеров; после выбора тарифа – месячную цену подписки.
- Вращайте карту и меняйте масштаб. Наведите на точку, чтобы увидеть модель, её усилие и точные показатели.
- Выберите две конфигурации для сравнения. В разделе «Таблица и сравнение по замерам» доступны плоские проекции «Цена × качество» и «Скорость × качество», таблица и экспорт. Основная 3D-карта остаётся на виду.
Тест над картой можно менять для исследования. Это меняет ось качества, таблицу и сравнение, а рекомендации продолжают учитывать деятельность, выбранную в начале. На странице есть пояснение и возврат к тесту этого профиля. Чтобы получить рекомендации для другой работы, меняйте «Деятельность».
Фильтр «Только Парето» убирает варианты, которые другой кандидат превосходит по выбранным трём показателям без проигрыша по любому из них. Остаются конфигурации с разными компромиссами. Среди них всё равно нужно выбрать ту, чьи цена, качество и ожидание подходят вам.
В варианте Sol есть дополнительный переключатель «Все / Эффективные». Если «Только Парето» уже включён, оба набора могут совпадать: поэтому количество точек и сама карта не изменятся. Счётчик показывает, сколько вариантов находится в текущем наборе.
Один промпт, две 3D-карты
Я дал GPT 6.1 Sol и Opus 5.5 одинаковое задание: сделать вращаемый график с осями X, Y и Z на одних исходных данных. Хотелось, чтобы его можно было смотреть с разных сторон и чтобы он был красиво сделан. Выбор библиотеки, оформление и способ взаимодействия оставил агентам.
Sol работал с усилием Max, Opus – с Medium. Оба выбрали готовую библиотеку Three.js. Задание было общим; отдельно различались рабочие папки и порты, чтобы агенты не мешали друг другу.
Мне понравились оба варианта, поэтому я встроил их в одну страницу и добавил переключатель. Подписи «GPT 6.1 Sol · Max» и «Opus 5.5 · Medium» относятся к агентам, создавшим интерфейс. Усилие моделей, которые вы сравниваете как точки на карте, указано у самих точек.
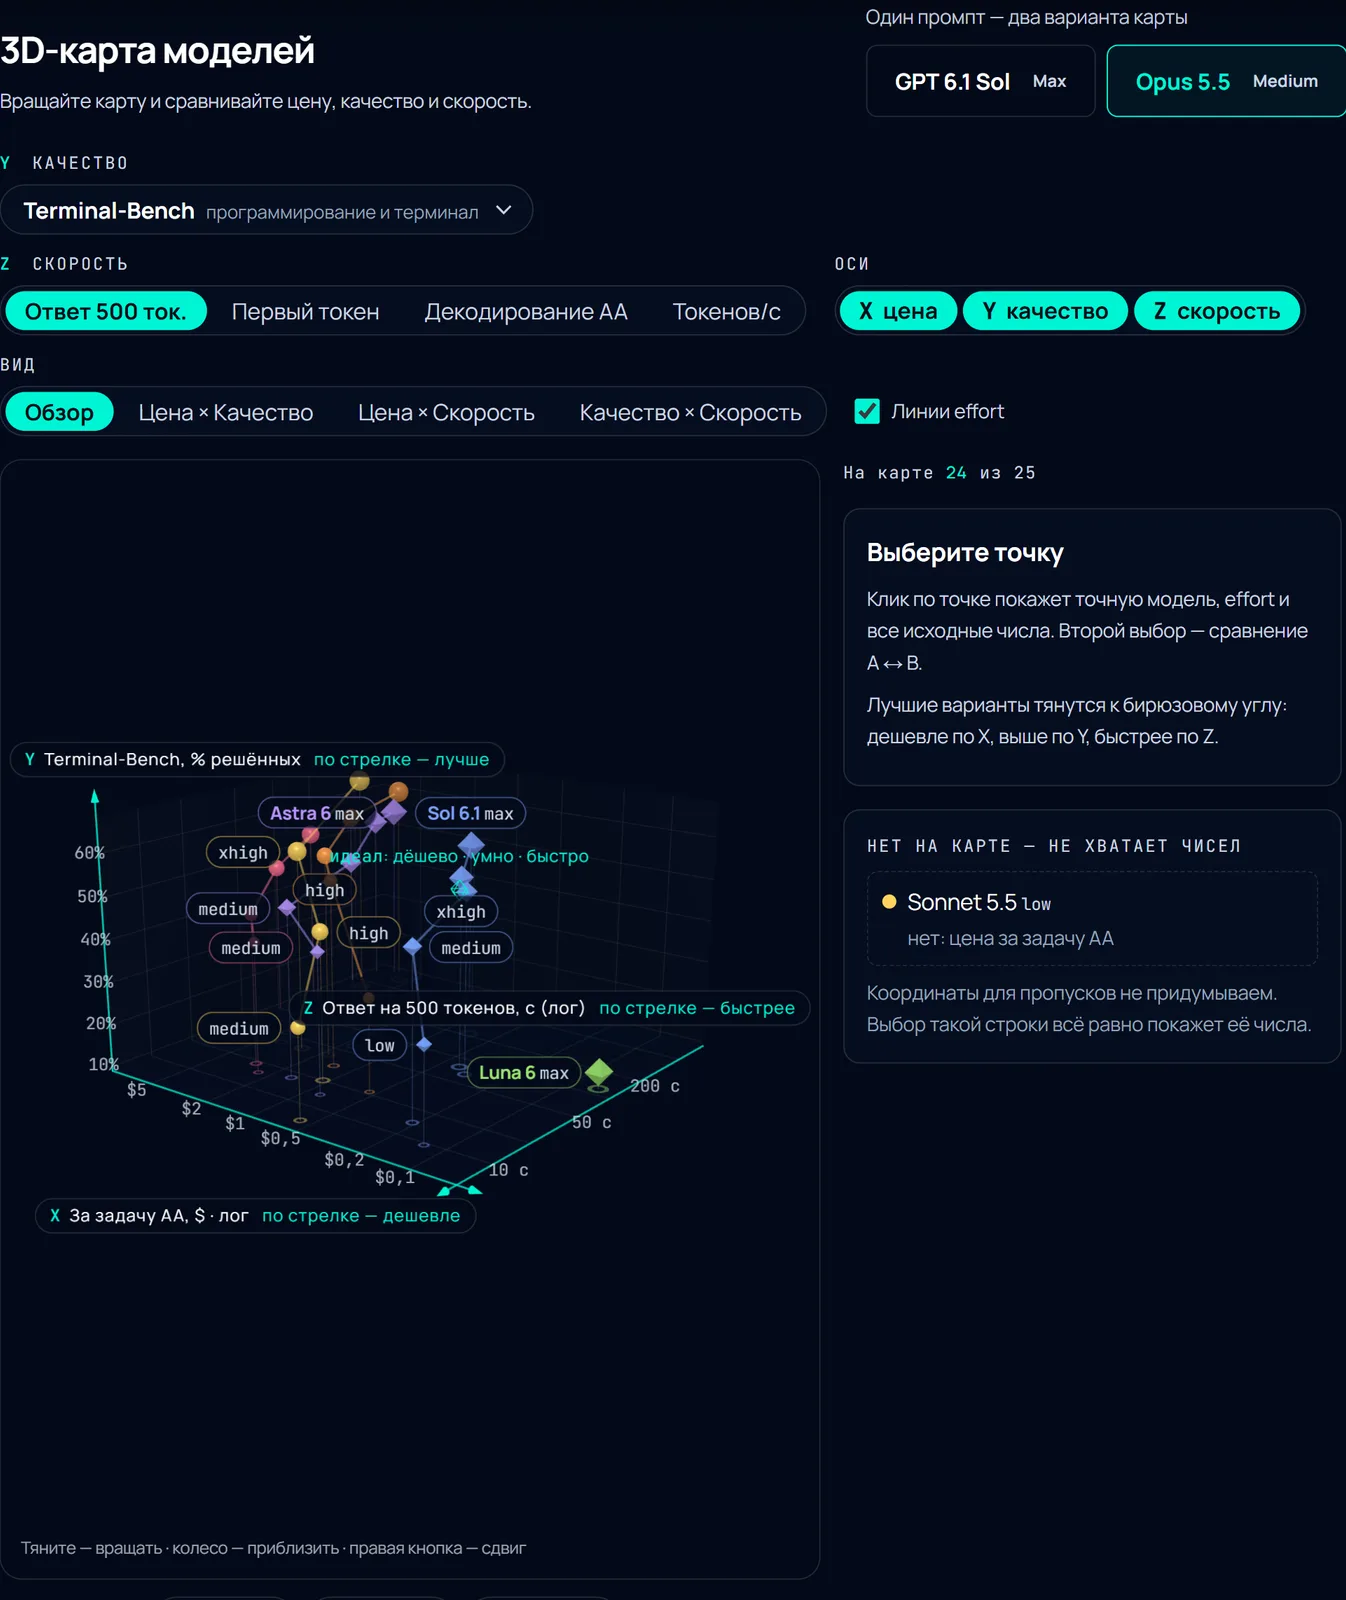
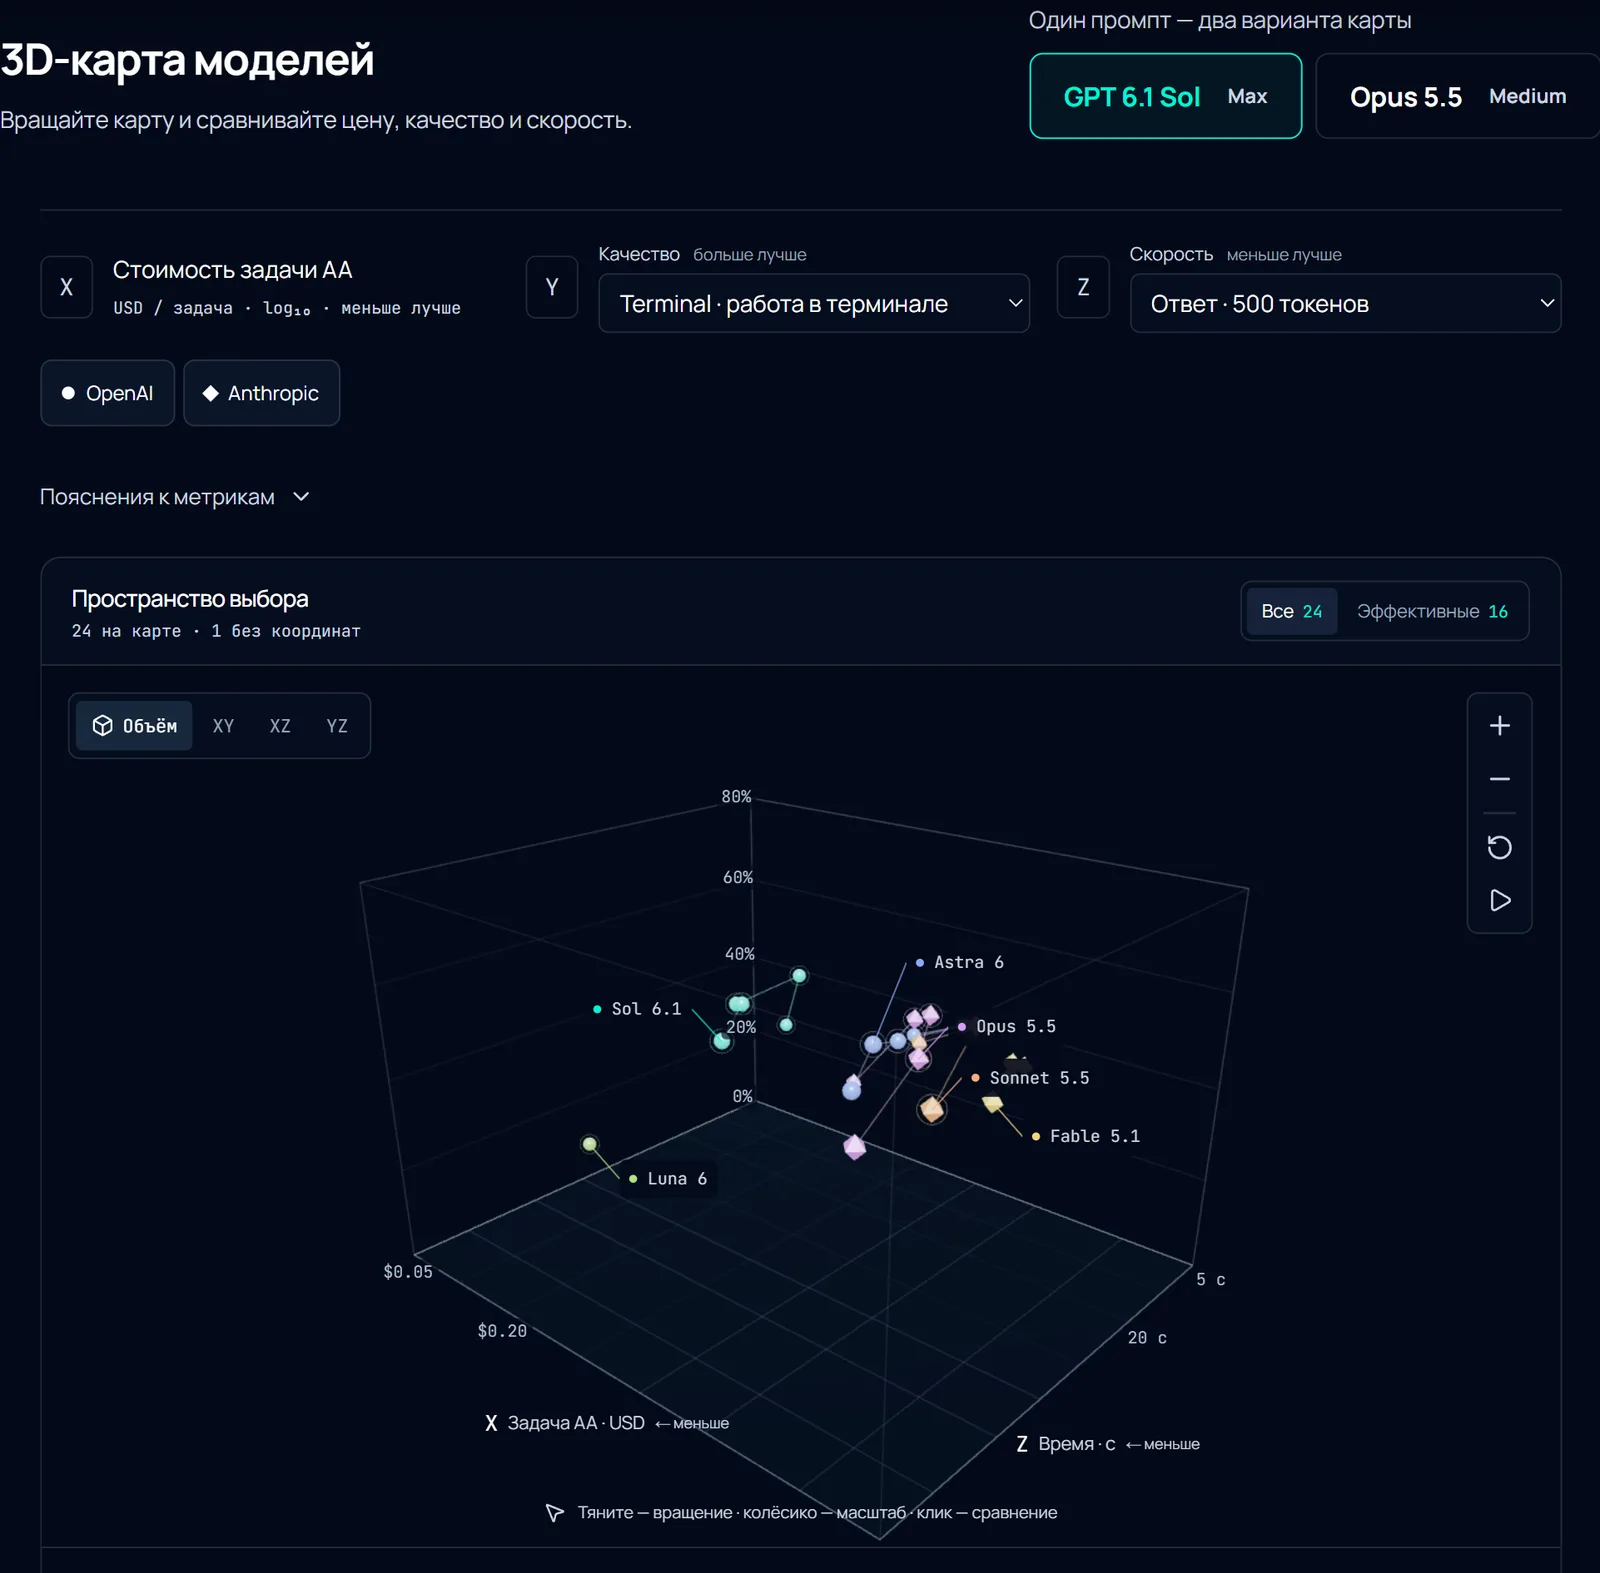
Можно переключаться между ними и смотреть, где вам легче прочитать оси, найти точку и сравнить соседние варианты. Это один опыт разработки интерфейса с разными усилиями рассуждения. По нему я не определяю, какая модель лучше во всех задачах.
О принципах выбора модели для рабочего проекта у меня есть отдельная статья. Здесь эти вопросы можно проверить на интерактивной карте. Откройте Model Compass, выберите свою деятельность и сравните два подходящих варианта – следующий шаг уже за проверкой на вашей работе.
Обсудить выбор моделей и сравнение двух карт можно в моём Telegram-канале.
