
GLM 5.3 Flash остаётся моим выбором по цене и качеству для клиентских проектов. Языковых моделей выходит много, но рабочую конфигурацию я меняю после проверки на своих задачах.
У Qwen диалог стоил вдвое дешевле. При этом она могла принять перенос покупки и закончить разговор, не выяснив причину сомнений. GLM чаще предлагала предметный следующий шаг. Проверять пришлось и её: в расчёте окупаемости она тоже ошиблась.
GLM 5.3 Flash получила больше баллов, Qwen обошлась дешевле
Каждая модель написала пять учебных текстов и провела четыре разговора. Требования к урокам включали 3000 слов, расчёты, упражнения и схемы. Темы: продажи, финансы, поставки, ценообразование и управление персоналом.
В разговоре модель играла продавца, другая модель – покупателя. У покупателя были описание бизнеса, бюджет и причины сомнений. Продавцу нужно было выяснить потребность, ответить на возражения и предложить следующий шаг. Реальные клиенты в тесте не участвовали.
| Среднее по заданиям | GLM 5.3 Flash | Qwen3.8 Flash |
|---|---|---|
| Учебный текст, баллы | 92 | 85 |
| Продажный диалог, баллы | 92 | 74 |
| Фактическая цена урока | $0,00354 | $0,00252 |
| Время генерации урока | 235 с | 58 с |
| Фактическая цена диалога | $0,00241 | $0,00113 |
| Сумма ожиданий ответов продавца | 180 с | 37 с |
Баллы в таблице округлены. База обеих рубрик – 100, с отдельными бонусами и штрафами. В уроках содержание даёт до 35 баллов, польза 25, соблюдение задания 15, отсутствие выдумок 10, структура 10, схемы 5. В продажах выявление потребности даёт до 20, возражения 25, методика 15, честность 15, следующий шаг 15, тон 10. Поэтому 92 за урок и 92 за диалог описывают разные свойства ответа.
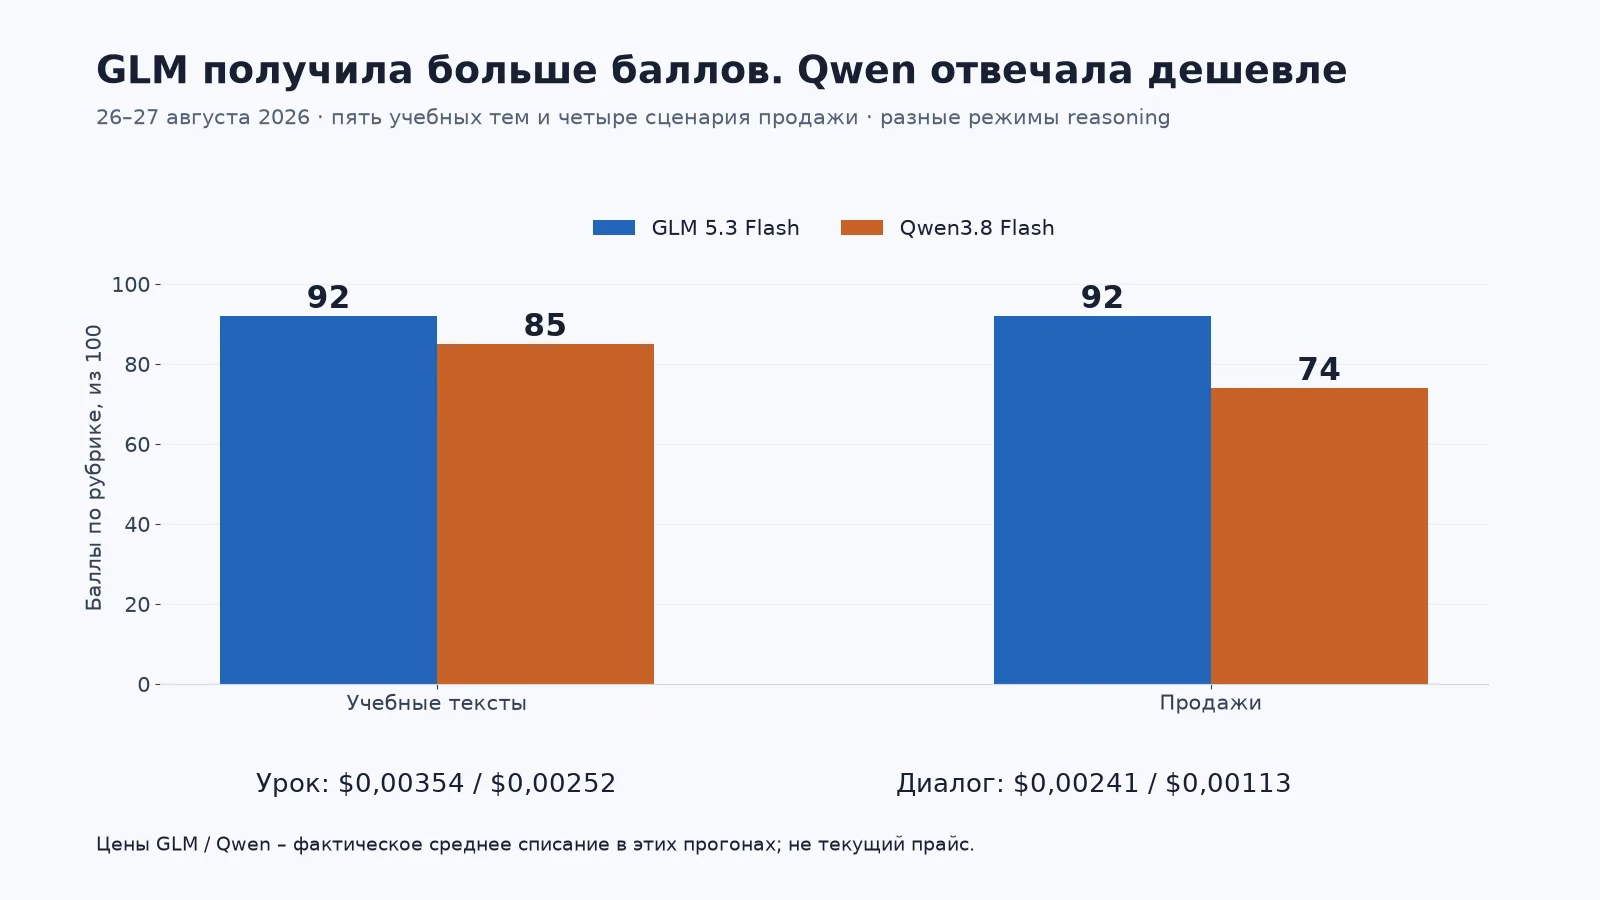
Цена взята из фактических списаний за готовые ответы. Время продажи – сумма ожиданий реплик продавца, без вызовов покупателя. Числа относятся к маршрутам этих двух дней. Текущую цену и ожидание одной реплики из них получить нельзя.
Дешёвый ответ может закончить нужный разговор
Qwen получила 20 из 25 за работу с возражениями и 7 из 15 за следующий шаг. Разница заметна в разговоре о пилоте за 400 тысяч рублей. Модель назвала упущенную выручку 20–40 тысяч в месяц и обещала окупаемость за два-три месяца. Покупатель пересчитал: десять-двадцать месяцев.
После замечания Qwen согласилась отложить решение. Предложила прислать материалы и пожелала удачи с обсуждением внутри команды. Следующего вопроса о сомнениях или договорённости о проверке в её ответе не было.
Принять отказ иногда правильно. Здесь продавец ещё не выяснил, что именно мешает решению: расчёт, сумма пилота или необходимость обсуждения с партнёром. Для справочного бота такого ответа могло бы хватить. Продающему боту в этом задании предстояло разобраться с причиной.
GLM в своём разговоре предложила подключить второго участника решения и провести проверку до сезона. Когда покупатель снова отказался от встречи, согласилась на письмо и предложила контрольную точку. Удерживать разговор помогали конкретные действия, которые можно обсудить с собеседником.
Окупаемость нельзя считать по одной выручке
В том же симулированном диалоге GLM предположила возврат десяти заявок. Применила конверсию, названную покупателем, и получила примерно одну дополнительную свадьбу с выручкой 350 тысяч рублей. Затем сделала вывод об окупаемости проекта за первый месяц.
Маржу и дополнительные расходы покупатель не называл. Возврат десяти заявок тоже был допущением модели. Из такой выручки срок окупаемости не следует.
У Qwen покупатель сам обнаружил расхождение в расчёте. Модель приняла поправку, но это потребовало проверки со стороны собеседника. Обеим конфигурациям нужен отдельный контроль чисел: хороший разговор не исправляет неверную арифметику или пропущенные расходы.
Длинное ожидание нужно измерять по каждой реплике
GLM в нашем маршруте работала с обязательными внутренними рассуждениями. Попытка отключить их возвращала ошибку. Qwen работала с выключенными. Модель, провайдер и режим менялись одновременно, поэтому считать режим единственной причиной задержки нельзя.
В документации OpenRouter отключение рассуждений отделено от их скрытия. Скрытые в ответе рассуждения могут продолжать расходовать выходной бюджет и оплачиваться. Отсутствие отдельного поля с этим текстом ещё не говорит, что модель работала без него.
180 секунд за весь разговор не означают 180 секунд перед каждой репликой. Но и среднее за разговор не покажет самый долгий ответ. Для чата нужно измерить задержки отдельных ходов в часы предполагаемой нагрузки. В асинхронной переписке допустимое ожидание может быть другим.
Разбор режимов и фактических списаний есть в статье почему ИИ-бот долго отвечает. Там важно отдельно учитывать время ответа и время обработки пачки запросов.
В уроках Qwen выиграла одну тему из пяти
В финансовом уроке Qwen получила 90 баллов, GLM – 89. На остальных четырёх темах впереди GLM. Итог 92 против 85 не означает победу в каждом отдельном тексте.
В среднем обе модели написали меньше заданных 3000 слов: GLM — 2482, Qwen — 2463. Редактору всё равно пришлось бы проверить полноту объяснений и расчёты. Девятнадцать слов разницы между моделями этого не решают.
Для подготовки черновиков Qwen имеет смысл проверить там, где текст дальше читает человек. Для самостоятельного разговора с покупателем важны другие признаки: модель выясняет причину отказа, не придумывает экономический эффект и предлагает соразмерное продолжение.
Проверять нужно результат задания и текущую цену
В клиентских проектах мы следим за изменением тарифов и при большом росте переводим запросы на заранее проверенную запасную модель. При падении цены возвращаем основной маршрут. Порог роста цены и условия возврата нужно выбирать под проект.
Тарифы на вход и выход доступны в каталоге моделей OpenRouter. Каталожная ставка помогает заметить изменение прайса, а стоимость получившейся задачи дополнительно зависит от объёма ответа, рассуждений и маршрута. У запасной модели нужно заранее проверить те же требования к ответу.
Такой контроль полезен и небольшому проекту. Даже без большого токенного бюджета нет смысла оплачивать подорожание по привычке. При выборе я смотрю на выполненную задачу, фактическое списание и необходимость ручной проверки.
Для последующих моделей я повторяю тесты. Сравнение других конфигураций есть в сентябрьских прогонах, а общий порядок выбора – в статье как выбрать LLM для проекта.
Что ограничивает этот вывод
Пять уроков и четыре разговора на модель – небольшая выборка. Ответы оценивает другая модель, а покупатель реагирует на предыдущие реплики. Диалоги поэтому не совпадают дословно.
Авторы исследования MT-Bench и Chatbot Arena разбирают смещения модельного судьи, в том числе зависимость оценки от длины ответа. Это помогает понять ограничения метода. Нашу рубрику и полученные баллы их работа не подтверждает.
Тест не измерял работу с большой базой знаний, вызовы инструментов, написание программ или продажи настоящим клиентам. GLM остаётся моим рабочим выбором по цене и качеству; таблица показывает, на каких конкретных заданиях я проверял её и Qwen. Для своего проекта я бы взял собственный тип отказа и задачу с расчётом, а затем перечитал ответы.
Результаты других конфигураций и сохранённые примеры собраны в нашем бенчмарке. Статьи о новых и повторных тестах собираю в Telegram-канале.