
Тест LLM в октябре 2026 вернул меня к Luna: 92 балла за уроки и 81 за продажи. GLM, которая долго была моим фаворитом, получила 64 и 65. В августовском сравнении GLM с Qwen у неё было 92 и 92, и я выбирал её по соотношению цены и качества.
Меня в этих результатах волнует стабильность. Не хочется заново выбирать модель после каждого обновления или смены настроек. Пока Luna выглядит для моих уроков надёжнее остальных. Но разницу между прежними и нынешними баллами пришлось проверить: часть её появилась из-за условий теста и самого оценивания.
Тест LLM в октябре 2026: результаты двух задач
В основной прогон вошли пять моделей. Каждая подготовила пять уроков на русском и прошла четыре диалога в роли продавца. Ниже средние баллы, округлённые до целого; шкалы уроков и продаж различаются.
| Модель | Уроки, баллы | Продажи, баллы |
|---|---|---|
| GPT-6 Luna | 92 | 81 |
MiniMax M3.1 Flash :free |
71 | 80 |
| GLM 5.3 Flash | 64 | 65 |
| DeepSeek V4.1 Flash 1017 | 72 | 73 |
| Claude Haiku 5.5, max | 46* | 74 |
У Haiku два урока вернулись пустыми, один оборвался. Эти попытки сохранены, но 46 нельзя читать как оценку только содержания. Ниже – разбор причины и отдельный контроль на high.
Шестым кандидатом была Qwen3.8 Flash Next. После 15 ответов с ограничением частоты запросов от общего пула провайдера получить материал не удалось. Оценки качества у неё нет.
Для всех пяти моделей основного прогона через OpenRouter запрашивался режим рассуждений max. Лимит составлял 128 000 выходных токенов на урок и 65 536 на реплику продавца. Токены – единицы текста, которыми API считает объём запроса и ответа; в выходной лимит могут входить и внутренние рассуждения.
Маршруты к провайдерам были закреплены. Одинаковое слово max в запросе при этом не доказывает одинаковое количество вычислений внутри разных моделей. Эту границу сравнения сохраняю рядом с результатами.
Покупателя играл Codex GPT-6.1-Sol на max: он продолжал разговор по ответам продавца, задавал вопросы и проверял ограничения. Тот же Codex оценивал полные тексты. Это модельный судья, который знал названия кандидатов; слепого сравнения здесь не было.
Урок оценивался по шести критериям. Содержание даёт до 35 баллов, практическая польза – до 25, выполнение задания – до 15. Точность и структура дают по 10, схемы – ещё 5. Отдельно применяются штрафы за ошибки, обрыв и нарушение языка. В продажах оцениваются выявление потребности, возражения, методика, честность, следующий шаг и тон.
Luna ровнее прошла пять разных тем
У Luna самый высокий средний балл за уроки и самый узкий диапазон между темами: от 87 до 94. У MiniMax он составляет 61–88, у GLM – 56–73, у DeepSeek – 63–84.
| Модель | Финансы | Цена | Персонал | Поставки | Продажи |
|---|---|---|---|---|---|
| Luna | 91 | 93 | 87 | 94 | 94 |
| MiniMax | 61 | 63 | 72 | 72 | 88 |
| GLM | 62 | 62 | 68 | 73 | 56 |
| DeepSeek | 68 | 84 | 63 | 69 | 75 |
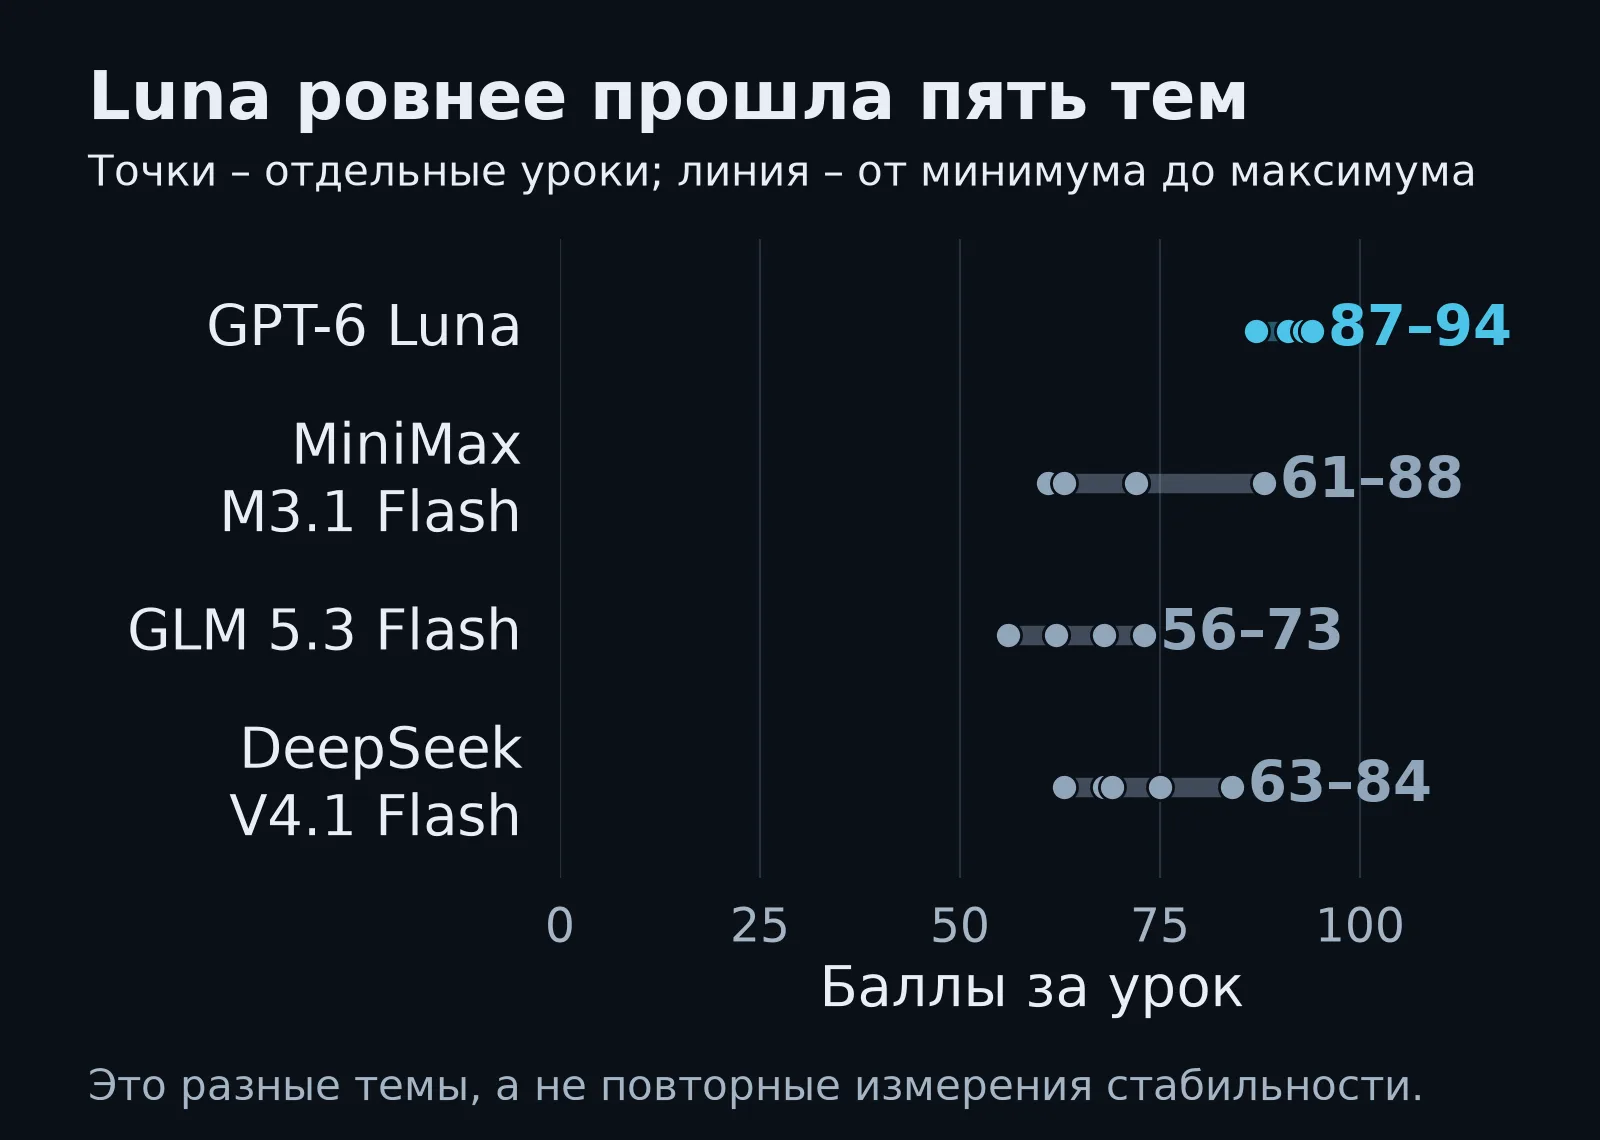
Для меня это полезнее одного среднего числа. У MiniMax хороший урок о продажах, но финансовый материал требует заметно больше исправлений. У DeepSeek сильнее получилось ценообразование, слабее – персонал. Если курс состоит из разных бизнес-тем, такой перепад придётся учитывать при проверке.
Здесь я называю ровностью результат на разных темах. Стабильность при многократном повторении одного запроса этот прогон не измеряет. Высокий балл также не гарантирует, что ученики усвоят материал: обучение людей в тест не входило.
За что модели потеряли баллы
Основные потери связаны с расчётами, выполнением задания и поведением в диалоге. Красивого объяснения недостаточно, если из него следует неверное финансовое решение.
Luna – 92 за уроки, 81 за продажи. В уроках верно связала бюджет, денежный поток и маржинальность. Расчёты скидок и запасов в основном корректны, а высвобождённые часы не превращаются автоматически в денежную экономию. До максимума не хватило заданного объёма и точности отдельных формулировок: например, ссылка на Gallup получила неверный год.
В продажах Luna часто аккуратно ограничивает обещания, но поздно выясняет скрытый контекст. В разговоре с финдиректором важный переход клиента на другую учётную систему обнаружился после подсказки. Из четырёх диалогов только один закончился согласованным следующим шагом – бесплатной предварительной проверкой.
MiniMax – 71 и 80. В диалогах близка к Luna: умеет ограничивать технические обещания и переносить проверку рискованного подключения до оплаты. Но в одном сценарии не сразу учитывает общий бюджет клиента, а в ответе появляется китайский фрагмент.
В уроках языковые вставки встречаются вместе с арифметическими ошибками. Например, пять дней при выручке 10 млн рублей в месяц оцениваются примерно в 167 тыс. рублей. При условных 30 днях в месяце получается около 1,67 млн – ошибка в десять раз. В другом уроке 340 / 1060 превращается в 33,3% вместо 32,08%.
В тесте использовался временно бесплатный маршрут MiniMax. Для расчёта обычной цены отдельно проверен официальный тариф: $0,15 за миллион входных и $0,60 за миллион выходных токенов на дату проверки. Нулевое списание по :free не делает исправление учебного материала бесплатным.
GLM – 64 и 65. Структура уроков хорошая, но ошибки затрагивают смысл расчётов. Срок, на который хватит денег, считается по всему оттоку, хотя при продолжающихся поступлениях нужен чистый расход. В уроке о продажах сохранённые заявки превращаются в сделки, а выручка подставляется в расчёт окупаемости как прибыль.
Есть и потери за английские заголовки и обычные фразы внутри задания на русский текст. Язык судья оценивает отдельно от знаний по теме. В диалогах GLM несколько раз предлагает условия, которые не снимают главный риск клиента, и исправляется после возражений.
DeepSeek – 72 и 73. Хорошо разобрала цену скидки и переговоры о ней. Но в уроке о персонале уже чистая экономия повторно уменьшается на затраты. В уроке о поставках неверно описана шкала обнаружения в методе оценки рисков FMEA: высокий балл означает, что отказ труднее обнаружить заранее.
В продажах сильнее разговор с техническим директором: модель выясняет роль службы безопасности и предлагает документы до доступа к данным. С финдиректором ошибается в трудозатратах и сумме этапов, а в другом сценарии показывает окупаемость по выручке без маржи. Позднее исправление помогает разговору, но исходная ошибка остаётся в оценке.
Haiku получила 46 за уроки, включая два пустых ответа. Сначала пришлось проверить, что именно вернул API. Штрафовать содержание пустого ответа как будто это обычный слабый урок было бы неверным объяснением результата.
Haiku: обычный запрос на max исчерпал лимит
Проблемные ответы пришли от обычной anthropic/claude-haiku-5.5 через Anthropic с обычным приоритетом. Это не batch и не flex. В финансовом уроке из лимита 128 000 токенов на рассуждения ушло 127 998, в HR-уроке – все 128 000. Видимого текста не осталось.
Для проверки маршрута тот же финансовый запрос отправили через Google Vertex, сохранив max и лимит. Получился частичный урок, но ответ снова завершился по длине.
Это согласуется с документацией Anthropic о рассуждениях: на max их длина не ограничивается отдельным внутренним бюджетом, а общий лимит делится с ответом. В руководстве OpenRouter для Claude 5.5 также указано, что отдельный токеновый бюджет рассуждений не передаётся как жёсткий предел.
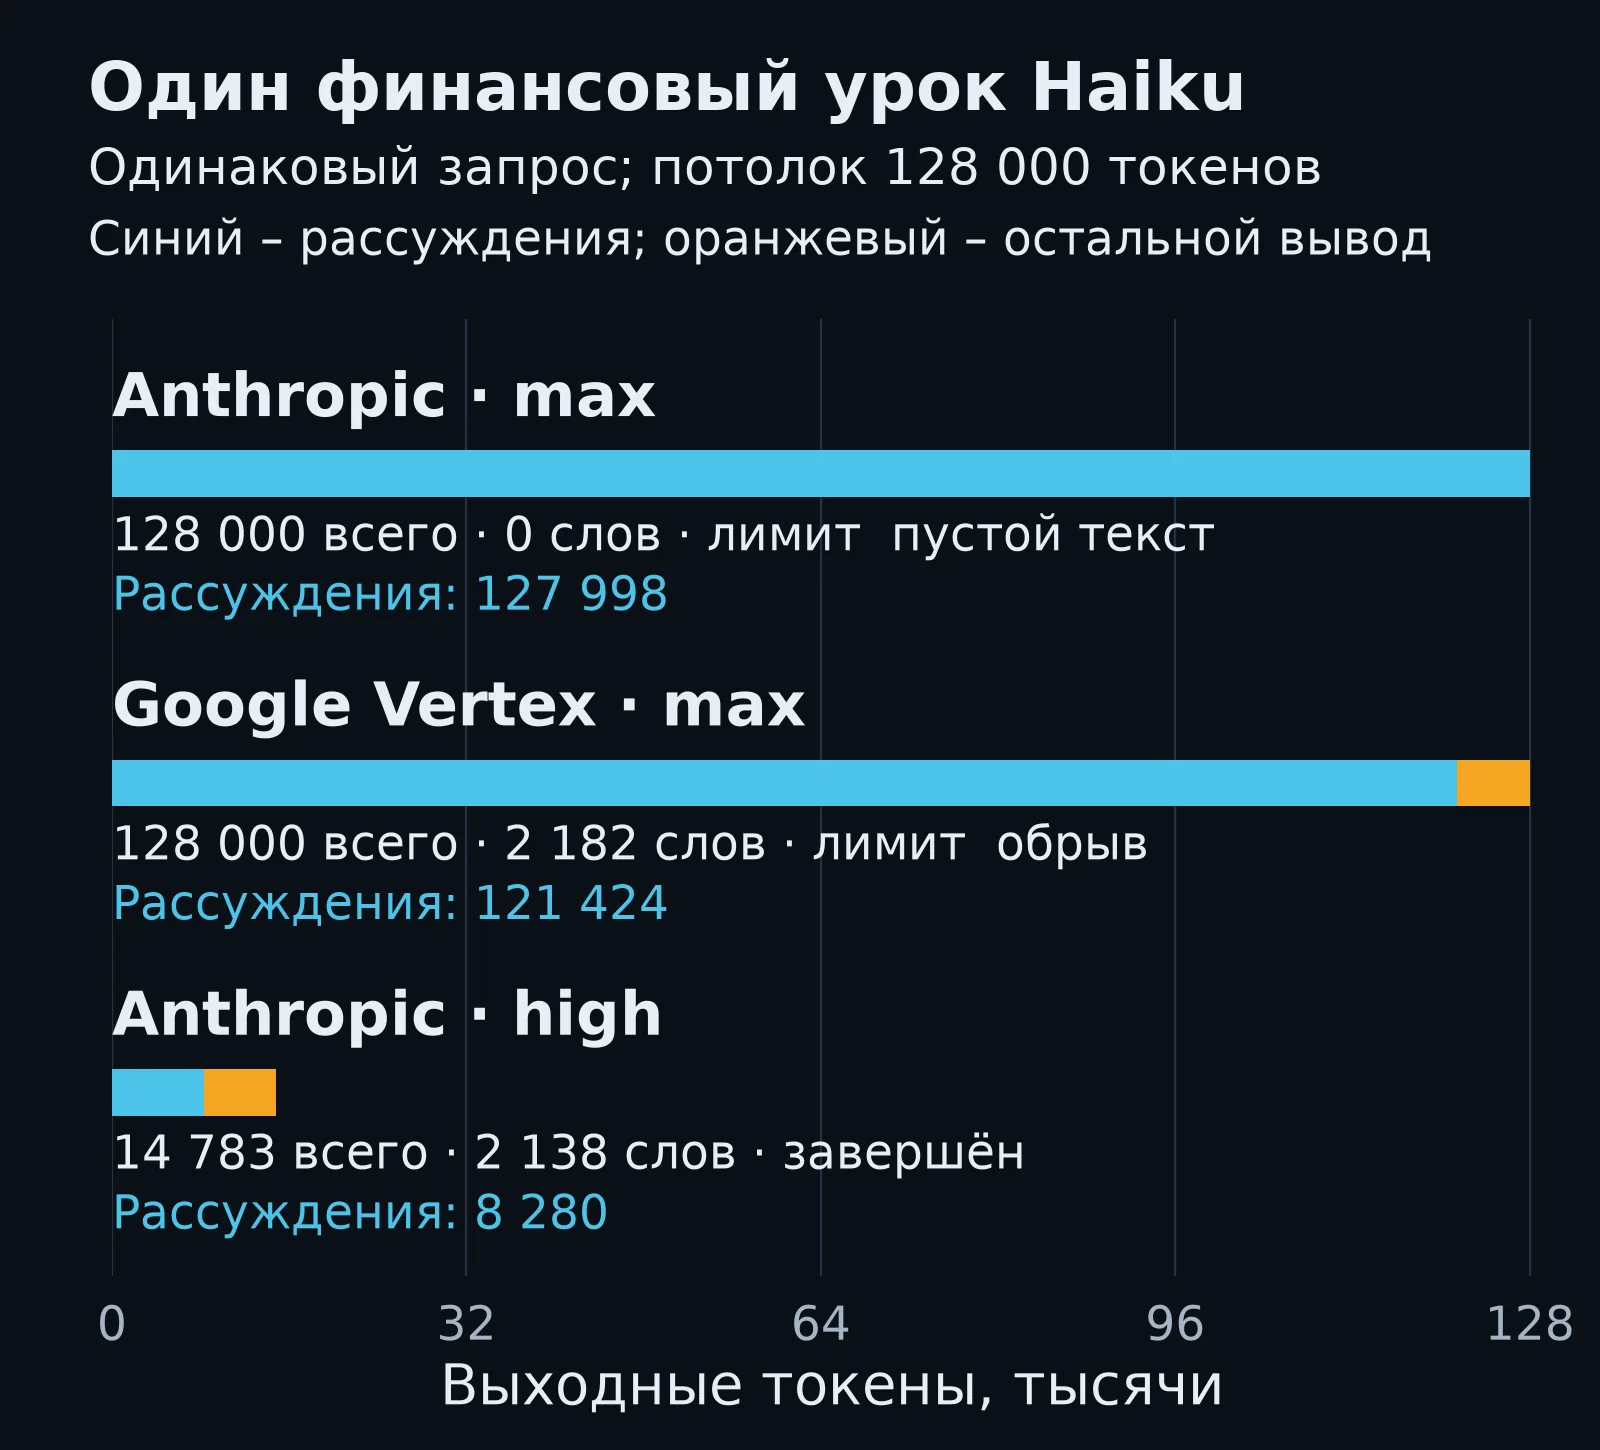
После этого проведён отдельный контроль на high. Все пять исходных заданий и лимит 128 000 сохранены; использовался тот же маршрут Anthropic. Каждый урок завершился. Средний балл – 72, точное значение – 71,8.
| Haiku high, отдельный контроль | Баллы |
|---|---|
| Финансы | 60 |
| Ценообразование | 79 |
| Персонал | 71 |
| Цепочки поставок | 78 |
| Продажи, учебный текст | 71 |
Полные ответы тоже потребовали проверки. В финансовом уроке модель перевернула рекомендацию о скидке за раннюю оплату. Если кредит дешевле выгоды от скидки, покупателю может быть выгодно занять деньги и оплатить раньше. В тексте рекомендовано обратное. Есть также недостающий объём, непереведённые заголовки и неточности в допущениях.
Поэтому я сохраняю два результата: неудачное завершение на max и полные, но требующие правки уроки на high. Балл 72 не подставлен вместо 46 в основную таблицу. Продажи Haiku на 74 относятся к исходному max; на high диалоги не повторялись.
В обсуждении своего теста на Hacker News Саймон Уиллисон отмечает большой прогресс Haiku 5.5 относительно 4.5 при рисовании пеликана. Его наблюдение не противоречит нашим урокам: оно относится к другой задаче и другому сравнению.
Старый высокий балл GLM тоже пришлось перепроверить
Падение с прежних 92 до нынешних 64 само по себе не доказывает, что GLM стала хуже. В августе была другая версия рубрики, настройки и условия диалога. Даже между прогонами 19 и 20 октября менялись глубина рассуждений, лимиты, маршрут и покупатель.
Четыре старых диалога GLM оценили заново, не генерируя их повторно. Прежняя средняя оценка составляла 92,25, повторная – 62,25. Тексты те же, разница – 30 баллов.
Это проблема сопоставимости оценок. Её нельзя объяснить изменением модели, которая уже давно выдала эти ответы. У LLM-судей бывают смещения к длине, порядку и собственному семейству модели; они описаны в исследовании MT-Bench и Chatbot Arena. Исследование не проверяло наши диалоги, но причина читать замечания судьи вместе с баллом вполне практическая.
В текущей волне для контроля перечитали 13 сохранённых эталонных ответов. Нового параллельного запуска Opus не было. Общую прибавку к баллам не применяли: изменения оценок контрольных текстов не поддерживали одну поправку для всех.
В нынешнем прогоне GLM получила низкие баллы за расчёты и выполнение задания. Для меня этого достаточно, чтобы пересмотреть прежний выбор. Утверждать по этим числам деградацию одной и той же версии было бы сильнее, чем позволяют данные. Эту же границу я разбирал в сентябрьском тесте моделей.
Для уроков я оставляю Luna первым кандидатом
Luna остаётся моим первым выбором для следующей проверки учебных материалов. Она ровнее прошла разные темы, а ошибки реже ломали расчёт или рекомендацию. Для продаж вывод осторожнее: 81 у Luna и 80 у MiniMax – слишком маленькая разница, чтобы обещать устойчивого победителя.
Ни один продавец не получил подтверждённого платного заказа. В тесте согласовывались только отдельные предварительные шаги. Реальные клиенты, договоры и оплаты потребуют отдельной проверки.
Меня по-прежнему беспокоит, насколько часто приходится перепроверять прежних фаворитов. Поэтому вместе с ответами я сохраняю настройки и объяснения судьи. Иначе при повторном тесте непонятно, что изменилось.
В базе результатов тестирования рядом с баллами сохранены объяснения по моделям и сценариям основного прогона. Начинать я советую с самого слабого ответа на близкую вам задачу. Дальше уже сравнивать стоимость и решать, сколько исправлений вы готовы принять. Общий порядок такой проверки есть в статье о выборе LLM для проекта.
В Telegram-канале я показываю следующие прогоны и причины, по которым меняю выбор модели.