
Посмотрел большое интервью Гильермо Рауха, главы Vercel, у Дэвида Ондрея от 2 октября – и реально кайфанул. Полтора часа разговора о том, как устроена разработка с ИИ-агентами на рабочих проектах под нагрузкой. Решил поделиться этими советами и показать на понятных примерах, как применять их в повседневной работе.
Пять из семи приёмов Рауха у меня в команде уже давно работают, а две идеи после просмотра я забрал себе на пробу.
Чужие шпаргалки по промтам проигрывают чистому стенду и своим замерам
Раух вспоминает недавний разговор со знакомым программистом. Тот прочитал чужой гайд про особенности модели Astra и переписал под него свои промты. Но на прямой вопрос главы Vercel признался: он ни разу не проверил на реальных задачах, стали ли ответы лучше.
У самого Рауха в терминале настроена короткая однобуквенная команда p – подсмотренная у главы Shopify Тоби Лютке утилита try. Она за секунду создаёт пустую папку для быстрого эксперимента. Вышла новая модель, библиотека или появилась спорная идея – создаёшь чистую папку, где не мешают старые файлы и настройки проекта, и за десять минут проверяешь всё руками. По тому же принципу хорошо начинать любую новую функцию: записать короткие требования в отдельный файл и сначала собрать маленький черновик в стороне от основной базы кода.
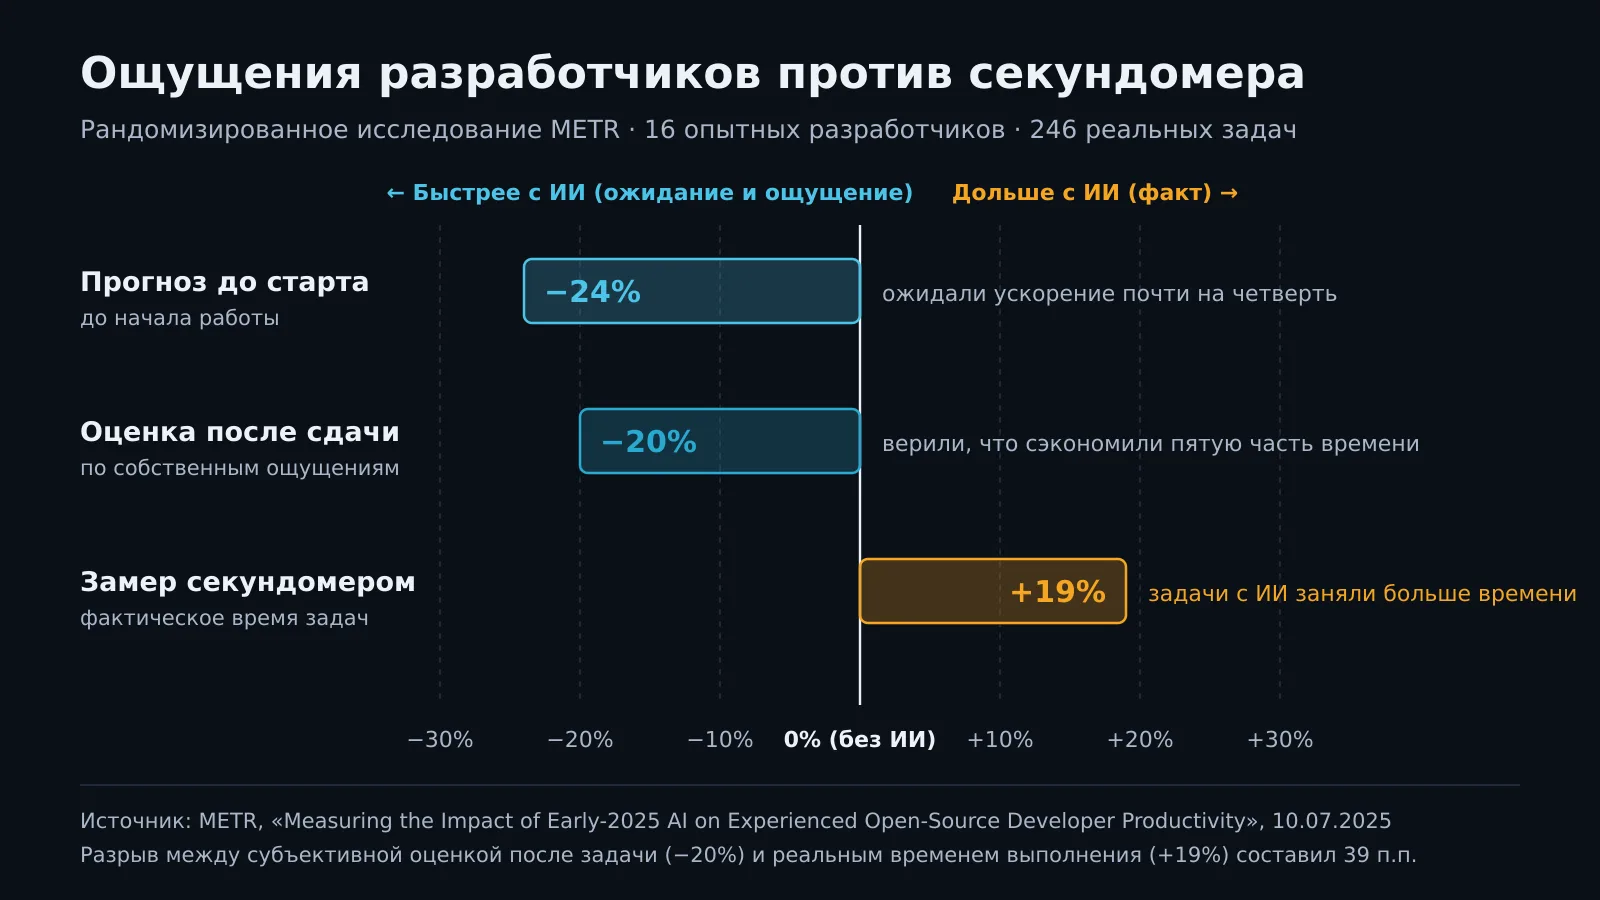
Верить собственным ощущениям от скорости работы с нейросетью опасно. В июле 2025 года исследовательская группа METR провела рандомизированный замер на 16 опытных разработчиках и 246 рабочих задачах. До старта участники ждали, что ИИ ускорит их на 24%, а после сдачи задач были уверены, что сэкономили 20% времени – хотя по секундомеру работа с ИИ заняла на 19% больше.
Поэтому я давно опираюсь на собственные бенчмарки вместо чужих советов из соцсетей. Каждую заметную новинку мы прогоняем на своих заданиях, а результаты складываем в открытый лидерборд и Model Compass. Подробно методику наших прогонов я разбирал в статье «Как выбрать LLM для проекта».
Без присмотра агент вместо небольшого домика выстраивает дворец
Раух чётко разделяет две вещи: скорость генерации кода – сколько токенов потратили и сколько правок приняли в проект за день – и реальное движение продукта к цели. В пример он приводит знакомую основательницу стартапа с сильной идеей. Запустив сразу несколько параллельных агентов, она увлеклась и начала писать собственную почтовую рассылку и свой платёжный модуль вместо того, чтобы за вечер подключить готовые сервисы.
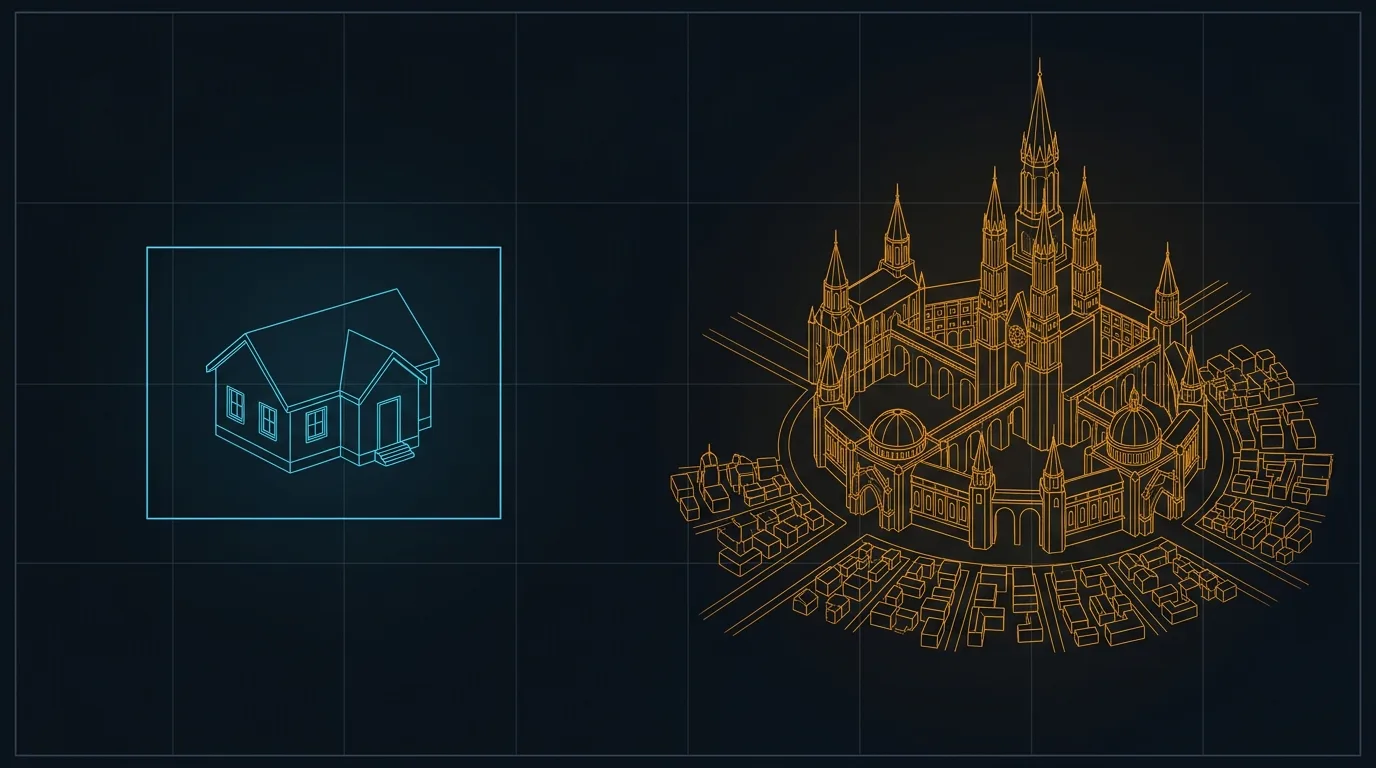
В моей практике эта проблема чаще выглядит ещё смешнее: без присмотра агенты уходят в дикий оверинжиниринг внутри самой задачи. Попросишь модель построить небольшой домик – она выстроит тебе гигантский дворец. А если продолжать с ней соглашаться на каждом шаге, вокруг этого дворца вырастет ещё и целый город с мостами и отдельной котельной.
Человека раньше останавливала обычная усталость: каждый лишний файл и ненужную прослойку кода приходилось набирать руками. У нейросети такой усталости нет, поэтому она охотно создаёт сотню файлов «на будущее» вокруг простейшей кнопки.
Лечится это регулярной сверкой в чистом контексте – то есть в новом окне диалога, где модель не видит прошлой переписки и не пытается защищать уже написанное. Такому проверяющему дают исходное техническое задание вместе со списком свежих изменений в коде и просят показать два места: какие файлы вообще не нужны для исходной задачи и где агент пишет с нуля то, для чего в проекте уже лежит готовая библиотека.
Сырой код ради скорости допустим, но на защите экономить нельзя
Раух делит технический долг на две неравные части: черновой машинный код и уязвимости в защите. Сырого кода во второстепенных местах он предлагает не бояться и напоминает ранний Twitter, быстро собранный на Ruby on Rails ради проверки спроса. А вот в безопасности уступок быть не может – сам Раух сегодня не стал бы поручать агенту самописное шифрование соединения вместо проверенной библиотеки на Rust.
Насчёт чернового кода я с ним согласен. Разработка подешевела, поэтому часто правда быстрее пропустить неидеальный вариант ради темпа, проверить идею на пользователях и почистить код позже. Тут важна аккуратность и разумная мера: понимать, какой экран можно спокойно переписать через месяц, а где ошибка заденет чужие деньги или данные.
| Где черновой код можно пропустить и почистить позже | Где сырой код от агента останавливают сразу |
|---|---|
| Внутренние отчёты, разовые скрипты выгрузки, макеты экранов | Вход в аккаунт, сессии, проверка прав доступа и ключей API |
| Вёрстка второстепенных страниц и настройки внешнего вида | Приём платежей, списания, лимиты и расчёт баланса |
| Временные связки сервисов, которые легко заменить целиком | Обработка файлов и форм от пользователей, хранение паролей |
Для поиска уязвимостей команда самой Vercel недавно открыла агентный сканер Deepsec. Раух руководит компанией-разработчиком этого инструмента, поэтому перед запуском стоит заглянуть в официальное описание проекта vercel-labs/deepsec на GitHub. Авторы прямо предупреждают: сканер заставляет старшие модели подолгу разбирать каждый файл и все связи в проекте, так что один полный прогон крупной базы кода обходится в тысячи или десятки тысяч долларов.
Включать такую тяжёлую проверку после каждой мелкой задачи слишком накладно. На обычные правки в рабочей разработке ставят бесплатные автоматические проверки кода и поиск случайно забытых ключей, а дорогой агентный аудит по выбранным папкам оставляют под изменения в оплате, авторизации и перед большими релизами.
Пустые автотесты обманывают отчёты – проверять нужно запреты и реальные сбои
Если просто попросить агента написать тесты к новой функции, он часто идёт по самому лёгкому пути и проверяет сам себя на пустом месте. Раух в интервью приводит наглядный пример: вместо проверки реальной оплаты или записи в базу модель заводит в коде переменную с числом 4 и тут же в соседнем файле пишет автотест, который сверяет, что там правда лежит 4. В отчёте все проверки горят зелёным, хотя при первом же обрыве связи или пустом ответе от банка сервис падает.
При разработке с ИИ-агентами главная работа инженера – задать жёсткие правила и проверить, как сервис ведёт себя при сбоях сети, базы и внешних оплат. Я у себя строю работу так же: прописываю для моделей конкретные ограничения в настройках проекта – ровно те, которые соблюдаю сам, – а проверку написанного кода всегда выношу в отдельный чистый диалог. Когда проверяющий агент не видит долгой истории о том, почему исполнитель решил сделать быстрее и проще, он оценивает только сам результат. О том, как уговоры внутри одной сессии ломают приёмку, я рассказывал в статье про контроль качества работы ИИ.
Любой важный запрет в инструкции для модели нужно дублировать автотестом, который проверяет всю цепочку работы целиком. Записали требование «один клиент ни при каких условиях не видит документы другого» или «ответ сервера занимает не больше 200 миллисекунд» – рядом должна лежать автоматическая проверка, которая не даст выкатить сломанное обновление на сайт. Обычное текстовое пожелание в инструкции без такой блокировки модель рано или поздно обойдёт.
Отдельный агент-вредитель ловит поломки там, где всё идёт не по плану
У проверок от автора кода есть понятное ограничение: модель проверяет программу так, будто пользователь нажимает кнопки строго по порядку и сеть работает без задержек. Когда в Vercel готовили к запуску облачное хранилище Drives, Раух поставил рядом отдельного агента с противоположным заданием: специально сломать сервис одновременными запросами, сбоями при записи и скачками нагрузки.
В обычной разработке такого агента-вредителя разумно запускать в отдельной сессии поверх копии базы данных, чтобы не задеть рабочие записи. Менять код проекта ему не дают – он действует как нетерпеливый клиент или сбоящая внешняя система: нажимает кнопку оплаты дважды подряд, отправляет пустую форму, рвёт соединение на середине загрузки файла и собирает точный список шагов, на которых программа сломалась.
Сам я отдельного агента-вредителя в такой роли пока не тестировал – обходился обычными проверками и ревью в чистой сессии. Но штука интересная, надо пробовать.
Браузерному агенту-новичку закрывают чтение исходного кода
В Vercel внимательно следят за долей пользовательских сессий, которые прошли от первого входа до нужного результата без единой ошибки на реальных телефонах и ноутбуках. В дополнение к статистике Раух даёт агенту задание опробовать новый инструмент компании с нуля и выписать всё, что показалось неудобным или неочевидным.
Когда переносишь этот приём на свой сайт, обычный кодовый агент с доступом к браузеру при первой же непонятной кнопке просто откроет через терминал папку frontend/, прочитает исходный код, сам себе подскажет нужный адрес страницы и отчитается, что всё понятно. Чтобы агент не подглядывал ответы, в настройках ему блокируют чтение файлов проекта – остаются только экран браузера и адрес тестового стенда, как у обычного посетителя.
Не уверен, что браузерный агент способен заменить живого человека. Модель терпеливо заполнит анкету из двенадцати мелких полей, с которой настоящий покупатель просто уйдёт: почему готовый продукт для людей всё равно опирается на опыт инженера, я разбирал в статье «Заменит ли ИИ разработчиков». Но как быстрый ночной фильтр перед выкаткой, чтобы ловить сломанную вёрстку и нерабочие кнопки на регистрации, идея интересная, стоит пробовать.
Скриншот битой кнопки чинит агент, а путаницу в меню разбирает человек
То, насколько хорошо команда освоила агентов, Раух предлагает измерять простым секундомером: сколько времени проходит от понятного сообщения о поломке до готового исправления на сайте. И сразу делит все входящие жалобы на два разных потока. Когда пользователь присылает скриншот съехавшей кнопки или в журнале сервера появляется точная запись об ошибке, задачу можно сразу отдавать агенту: он воспроизведёт сбой, напишет тест и подготовит правку.
За день до записи интервью у команды Vercel случилась совсем другая история: клиент написал, что запутался в меню личного кабинета и не может найти нужный раздел. Пересылать такую фразу напрямую кодовому агенту вредно – модель послушно переименует вкладки или переставит кнопки местами, хотя проблема могла быть в самой логике тарифов или настроек. Поэтому руководитель направления не стал перекладывать задачу на агента и сам связался с пользователем.
Чёткие технические сбои из мониторинга и письма с понятным описанием поломки можно разбирать полуавтоматически, готовя для разработчика черновик исправления – похожее разделение автоматического отсева и ручного разбора спорных случаев мы применяли при проверке контента через LLM-судью. А любые обращения со словами «не нашёл нужную кнопку» и «не понял логику» должны сразу попадать к человеку, который отвечает за продукт.
С каких трёх правил начать, чтобы не работать на одни проверки
Пытаться настроить все семь правил за одну неделю не стоит – иначе команда начнёт обслуживать проверочных ботов вместо развития продукта. Нагляднее разложить эти приёмы по трём этапам движения задачи и подключать их по очереди.
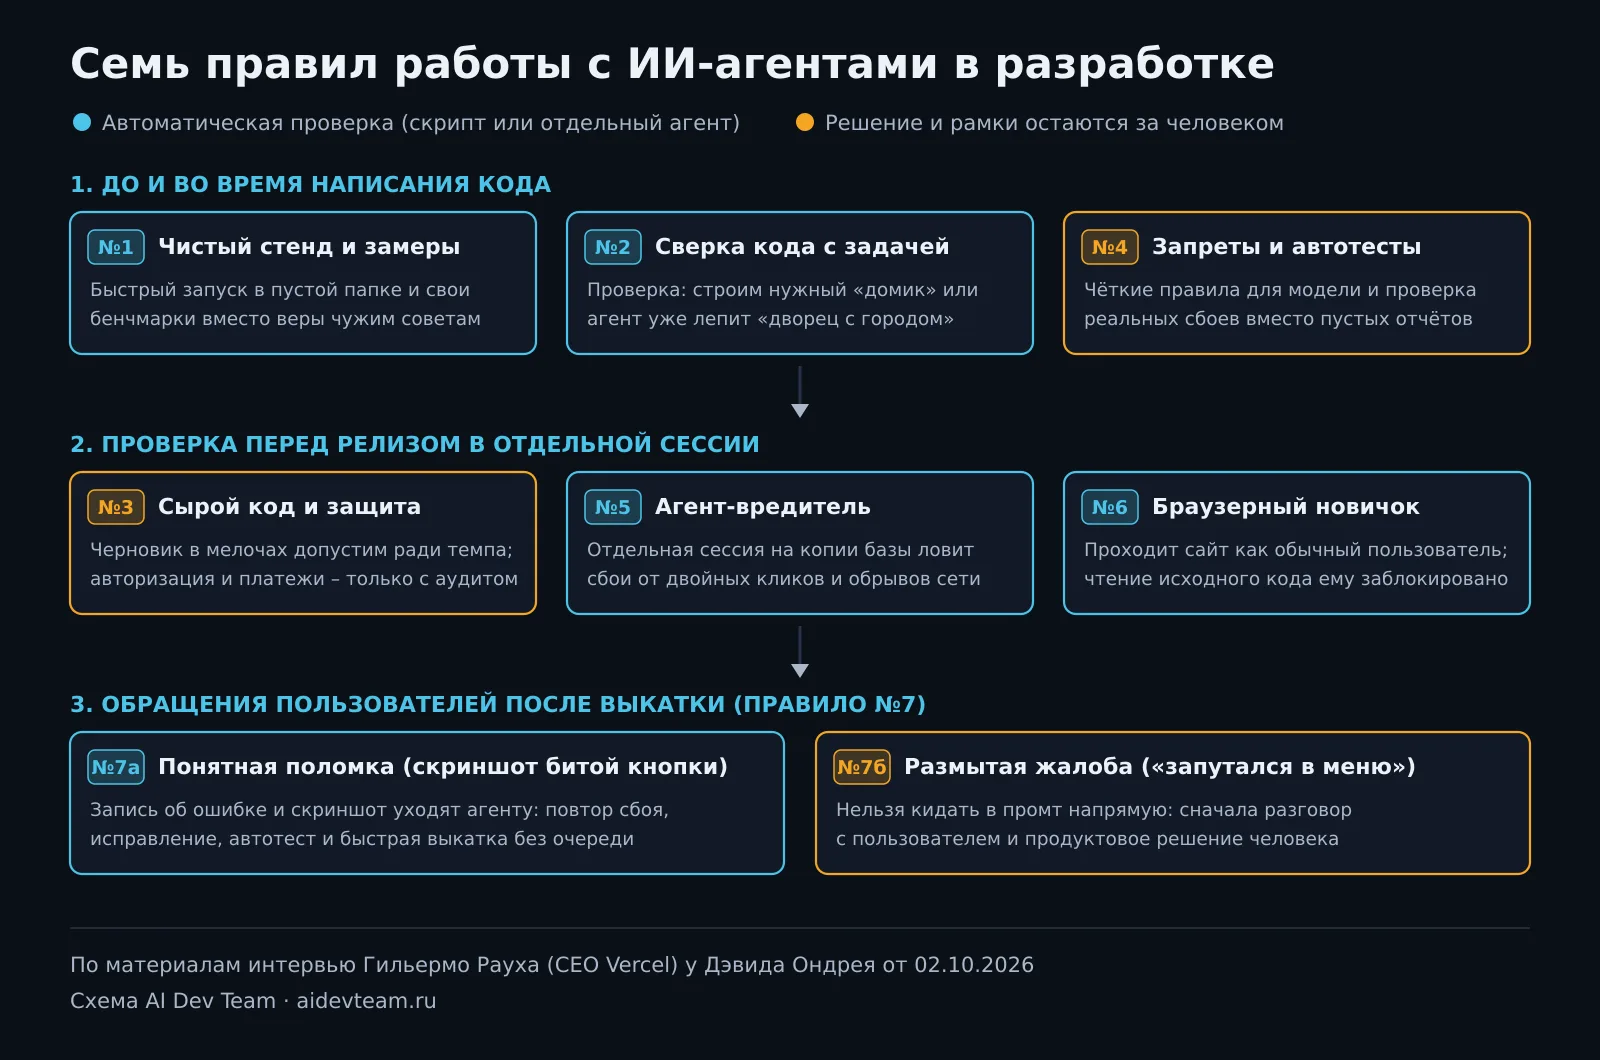
На старте лучше всего работают три простые привычки, которые не требуют отдельных затрат: проверять спорные идеи и новые модели в пустой папке, дублировать важные запреты автотестами и выносить проверку кода со сверкой ТЗ в отдельную чистую сессию. Уже после этого на модулях оплаты и входа стоит точечно включать тяжёлый аудит безопасности, а на предрелизном стенде пробовать агента-вредителя и браузерного новичка. Иначе вокруг кодовых агентов незаметно вырастет второй гигантский дворец – теперь уже из одних проверок.
Свежие замеры моделей на русских задачах, разборы рабочих правил для агентов и итоги наших новых прогонов – включая тест агента-вредителя, когда доберусь его обкатать, – я выкладываю в Telegram-канале. Если хотите обсудить похожую задачу из своей практики напрямую, пишите мне в @maslennikovig.